1. この章の目標
以下の考え方を学びます。
-
アルゴリズムの効率を測る「計算量」という考え方
-
アルゴリズムの基本演算の回数を、入力サイズの関数として評価する方法
-
同じ問題でも、アルゴリズムによって計算時間が大きく異なること
-
身近な整列問題を例に、具体的な計算量の分析手法
実際のプログラミングでも、このような視点でアルゴリズムを選択することが重要になります。
|
読み進め方
最初は、整列の具体例 → 時間計算量とO記法 → 実用的な整列アルゴリズム、の順で読み進めてください。 「厳密な定義」は折りたたんであります。後半の「発展:問題そのものの限界」では、アルゴリズムを工夫しても越えられない限界と、その証明を扱います。初読では結論だけ押さえて、証明は後から読んで構いません。 |
2. アルゴリズム
アルゴリズムとは、与えられた問題を解くための有限の手順のことです。問題には一般に、入力に対応する出力があります。この両者を結びつける手順をアルゴリズムといいます。
高校で習う、2つの整数の最大公約数を求める手順は、よく引き合いに出されるアルゴリズムの1つです。紀元前300年頃のユークリッドの『原論』に記されていることから、「ユークリッドの互除法」として知られています。
|
コンピューター関連の用語には、カタカナ語が多すぎることから、かつて様々な専門用語をカタカナを用いない日本語に翻訳する試みがありました。コンピューター分野のノーベル賞にあたるチューリング賞受賞者であるドナルド・クヌースによるコンピューター科学のバイブル「The Art of Computer Programming」の最初の和訳(サイエンス社、1978年〜)に、その試みの一部をみることができます。
算法は、日本産業規格JIS X 0001:1994(情報処理用語―基本用語)にも、アルゴリズムとともに併記されており、中国語でもアルゴリズムを算法といいます。 |
コンピューターに問題を解かせるときに、いつ計算が終わるのか、だいたいの見積もりができないと困ることになります。そこで、まずどのように問題の難しさを見積もるのか、簡単な問題を例に見てゆきます。
この章では、整列(ソーティング)問題を題材にして、アルゴリズムの計算量について解説します。計算量には、時間計算量と空間計算量があります。時間計算量はアルゴリズムの速さを示す量です。空間計算量はアルゴリズムで必要となる記憶領域の大きさを示す量です。難しい問題を解くときには、計算の途中結果を記憶しておくために、たくさんの計算用紙(メモリ)を消費してしまうことがあります。空間計算量は、その観点から計算量を考える指標です。この章では、主に時間計算量を扱います。
2.1. 整列(ソーティング)問題
与えられたデータを小さい順(昇順)、または大きい順(降順)に並べ替える作業は、様々な場面で必要になります。トランプを数の昇順に並べ替えたり、年賀状を人名の「あいうえお順」(辞書順)に並べ替えたり、日常でもたびたび整列問題を解いているはずです。このように、比較可能な複数の対象を順番に並べる作業を、整列(ソーティング)と呼びます。
データの要素が、数や文字列のように大小関係を比較できる対象であれば、あらかじめデータを整列しておくことで、目的の値を高速に探し出せるようにもなります(辞書や名簿で、目的の語や名前をすぐに見つけられるのと同じです)。
値は整数や文字列のように大小比較ができる対象であれば何でも構いません。文字列でも、人名のあいうえお順で並べ替える例のように順序付けが存在しています(文字列に一般に用いられる順序を辞書順とよびます)。
整列の例
【1】整数の並び
| 入力 |
\(\langle 9,1,4,3,7,6,2,3\rangle\) |
| 出力 |
\(\langle 1,2,3,3,4,6,7,9\rangle\) |
【2】文字列の並び
| 入力 |
\(\langle\text{dog, cat, rat, pig, fox, cow, bat}\rangle\) |
| 出力 |
\(\langle\text{bat, cat, cow, dog, fox, pig, rat}\rangle\) |
2.2. 整列アルゴリズム
挿入ソート
まず、もっとも単純な整列アルゴリズムの1つである挿入ソートを紹介します(挿入ソートと同様のシンプルな整列アルゴリズムとして、バブルソートや選択ソートが知られています)。
(1). 2番目の値をそれより左側の並びの適切な位置に挿入する
(2). 3番目の値をそれより左側の並びの適切な位置に挿入する
(3). 4番目の値をそれより左側の並びの適切な位置に挿入する
:
(\(n-1\)). \(n\) 番目の値をそれより左側の並びの適切な位置に挿入する
このアルゴリズムによって整列する例を以下に示します。 入力の並びとして先程の例【1】の
を用います。
図の赤い縦線より左の薄い青の部分が整列済みの部分、右が未整列の部分です。各行では、1つ上の行で赤線のすぐ右にあった値を、整列済みの部分の適切な位置に挿入します(挿入した値を濃い青で、挿入位置を探すときに比較した値を太い枠で示しています)。
-
はじめは、先頭の9だけを整列済みの部分とします。
-
「1を挿入」の行では、まず9と1を比較して、1の方が小さいため、9を1つ右にずらし、空いた先頭の位置に1を挿入します。(比較1回)
-
「4を挿入」の行では、4と9を比較して、4の方が小さいため、9を1つ右にずらします。次に、4と1を比較すると4の方が大きいため、空いた位置に4を挿入して、挿入作業はこれでおしまいです。(比較2回)
-
「3を挿入」の行では、3と9を比較して、3の方が小さいため、9を1つ右にずらします。次に、3と4を比較すると3の方が小さいため、4も1つ右にずらします。3と先頭の1を比較すると3の方が大きいため、空いた位置に3を挿入して、挿入作業はこれでおしまいです。(比較3回)
このように、挿入する値を、整列済みの部分の末尾から先頭に向かって順に比べ、自分以下の値が見つかったところで止まります。
比較回数が整列アルゴリズムの時間計算量を決定づけていますので、比較回数を数えることにします。計算量を考える場合は、一般に \(n\) 個の並びの中で、もっとも時間がかかる入力を与えた最悪のケースを考えます。\(k\) 回目の挿入では、整列済みの部分に \(k\) 個の値があり、最悪の場合はそのすべてと比較が必要になります。8個の並びでは挿入が7回あるので、最悪の比較回数は
となり、28回です。この入力例では実際の比較回数は図より
となり、22回で済んでいます。最後の行で右端の「3」を挿入するとき、すでに左側にあるもう1つの「3」と比べて「自分より大きくない」とわかった時点で止まるので、それより左の1や2とは比較しないことに注意してください。つまり、「9,7,6,4,3」の5つの値と比較するので、比較回数は5となります。
入力として与える値の並びの長さ(入力サイズ) \(n\) に対する最大の比較回数を \(T(n)\) とおくと、以下のようになります。
この式から、入力が大きくなったときに比較回数がどう増えるかを見てみましょう。
| 入力サイズ \(n\) | 最悪の比較回数 \(T(n)\) | \(n=1{,}000\) のときの何倍か |
|---|---|---|
1,000 |
499,500 |
1倍 |
2,000 |
1,999,000 |
約4倍 |
4,000 |
7,998,000 |
約16倍 |
10,000 |
49,995,000 |
約100倍 |
\(n\) が2倍になると比較回数はほぼ4倍、4倍になると約16倍、10倍になると約100倍です。これは \(T(n)\) の中で \(\frac12n^2\) の項が支配的だからです。\(n\) が大きいとき、\(\frac12n\) の項の影響は \(\frac12n^2\) に比べると微々たるものです。また、「2倍にすると4倍」という増え方は、係数が \(\frac12\) でも \(100\) でも変わりません。そこで、増え方だけに注目するときは、係数と小さい項を省いて \(T(n)=\text O(n^2)\) と書きます(「オー・エヌ二乗」と読みます)。この書き方の意味は、後の「時間計算量」の節で詳しく説明します。
挿入ソートのアルゴリズムのプログラム例が以下のコードです。あくまでも例示ですので、理解する必要はありません。このくらいのコード量で書けるということがわかれば大丈夫です。
a=[9,1,4,3,7,6,2,3]
n=length(a)

for i=2:n
    t = a[i]
    j = i - 1
    while j>=1 && a[j] > t
        a[j+1] = a[j]
        j -= 1
    end
    a[j+1] = t
end
このコードはプログラミング言語 Julia で記述してみました(なぜ Julia を用いたかというと、単に私が好きな言語だからです…)。
実際にこの手順で、挿入ソートが \(n\) 個の値を整列(ソート)するのに必要な比較回数(≒計算時間)を数えて、グラフにしてみました(本文のプログラムと同じ手順を実行して数えています)。
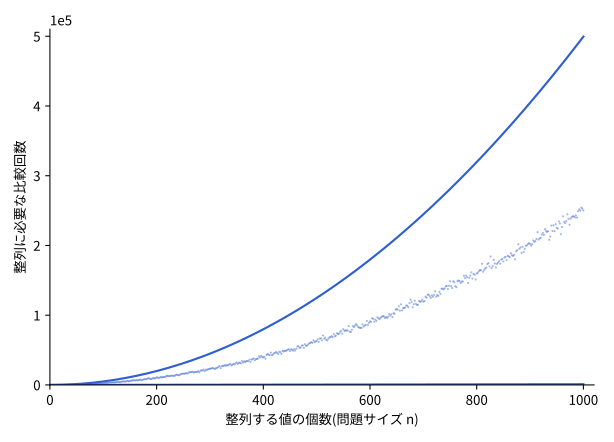
このグラフで、いちばん上の青い曲線は、
のように完全に降順に並んだ値の列を入力として与えた場合です。挿入ソートでは、このような入力が最悪の場合になります。この曲線は上で計算した \(T(n)=\frac12n^2-\frac12n\) と一致します。
いちばん下の、ほぼ水平にみえる緑の線は、もともと整列済みの
のような値の列を入力として与えた場合です。挿入ソートでは、このような入力が最良の場合となり、比較回数は \(n-1\) 回です。つまり、もっとも速く計算できる場合は、入力の値の数 \(n\) に比例する時間で済みます。この線がほぼ水平にみえるのは縦軸が最大50万回まであるためで、\(n=1{,}000\) でも999回しかありません。
真ん中のオレンジの点は、ランダムに並べ替えた値の列を入力として与えた場合の比較回数です。最悪の場合のおよそ半分の回数ですが、やはり放物線(2次関数のグラフ)の形に増えてゆくことがわかります。これが挿入ソートの平均的な計算量の様子です。
この整列(ソート)アルゴリズムは、値の性質としては大小比較しか用いていないことに注意してください。これ以外の情報を用いると計算量が変わってきます(後の「計数ソート」で扱います)。
選択ソート
挿入ソートと並んでよく引き合いに出される素朴な整列アルゴリズムに、選択ソートがあります。考え方はとても単純で、未整列の部分から毎回いちばん小さい値を選び、左から順に確定させていくだけです。
-
1番目に、全体の中から最小値を選び、先頭の値と入れ替える
-
2番目に、残りの中から最小値を選び、2番目の値と入れ替える
-
これを末尾まで繰り返す
下の図では、各行で残りの中の最小値を赤い丸で示しています。その値は、次の行で整列済みの部分(水色)の右端の位置に移り、もともとそこにあった値と入れ替わります。たとえば1行目で選んだ1は先頭の9と、2行目で選んだ2は2番目の9と入れ替わります。

選択ソートでは、\(n\) 個から最小値を選ぶのに \(n-1\) 回、次に残りの \(n-1\) 個から選ぶのに \(n-2\) 回……と比較するので、比較回数は入力によらず常に
回です。挿入ソートは整列済みの入力なら \(n-1\) 回で済みましたが、選択ソートはどんな入力でも、最小値を探すために残りをすべて調べるので、常に \(n^2\) に比例する回数の比較をします(後で説明する記号を使うと \(\Theta(n^2)\) です)。一方、値の入れ替えは各段階で1回まで、全体で高々 \(n-1\) 回で済みます。
バブルソート
バブルソートは、隣り合う2つの値を比べて、左の方が大きければ入れ替える、という操作だけで整列します。
-
並びの左端から右端に向かって、隣り合う2つを順に比べ、左の方が大きければ入れ替える(これを1回のパスとよびます)
-
1回のパスで、残りの中の最大値が右端まで運ばれて確定するので、次のパスでは確定した部分を除いて同じことを繰り返す
-
あるパスで入れ替えが1回も起きなければ、整列は完了している
大きな値が、水の中の泡(バブル)が浮かび上がるように右へ移動してゆくことが名前の由来です。まず、1回目のパスの様子を見てみましょう。
1回目のパスでは7回の比較で、最大の9が右端まで移動しました。各パスの終わりの状態を並べると次のようになります。
パス5の後にはすでに整列が終わっていますが、アルゴリズムはそれを知らないので、パス6で入れ替えが起きないことを確かめてから終了します。比較回数は \(7+6+5+4+3+2=27\) 回でした。最悪の場合(降順に並んだ入力)には、パスが \(n-1\) 回必要で、比較回数は挿入ソートや選択ソートと同じ \(\frac{n(n-1)}2\) 回になります。整列済みの入力なら、1回目のパス(\(n-1\) 回の比較)で入れ替えが起きず、すぐに終了します。
バブルソートは仕組みが分かりやすい反面、入れ替えの回数が多く、実際のプログラムでは挿入ソートより遅いのが普通です。後のコラムで紹介するクイックソートの考案者ホーアも、最初に思いついたバブルソートを「遅そうだ」として退けています。
計数ソート
「並びの値からの情報として大小比較の結果しか用いない」という前提条件をなくすと、もっと速いアルゴリズムが作れるかもしれません。たとえば、並びの値の範囲があらかじめわかっていて、比較的狭い範囲であったとします。前の例 \(\langle 9,1,4,3,7,6,2,3\rangle\) をもう一度用いると、値の範囲が1から9までに限られるとして、それがあらかじめわかっていたとします。すると、次のような方法が考えられます。
-
あらかじめ値の範囲1から9に対応する箱を9個用意しておき、各箱のカウントを0にセットしておく
-
\(\langle 9,1,4,3,7,6,2,3\rangle\) の先頭から値を1つずつ読み込む
-
1番目の値9 → 9番目の箱のカウントに1を加える
-
2番目の値1 → 1番目の箱のカウントに1を加える
-
3番目の値4 → 4番目の箱のカウントに1を加える
: -
8番目の値3 → 3番目の箱のカウントに1を加える
-

すると、上図のように \((1,1,2,1,0,1,1,0,1)\) の並びが得られます。後は先頭から順番にカウントをみてゆき、カウントの数だけ、対応する値を出力すれば、整列完了です。
1 2 3 3 4 6 7 9
値の個数を \(n\)、値の範囲の広さ(箱の数)を \(k\) とします。入力を読む手間は \(n\) 個分、箱を初期化して順に調べる手間は \(k\) 個分、結果を書き出す手間は \(n\) 個分です。したがって、全体の時間計算量は
となります(「\(n+k\) に比例する」と読んでください)。この例では \((n,k)=(8,9)\) ですが、これはすべての操作がちょうど \(8+9=17\) 回で終わるという意味ではありません。範囲の広さ \(k\) も時間とメモリを左右する点が大切です。また、計数ソートは値どうしを一度も比較していないことにも注意してください。
値の範囲があらかじめわかっていても、たとえば、64ビットで表現できる整数の範囲となると、コンピューターの記憶装置を使い尽くしてしまいますし、膨大な時間がかかることになります。以下に計数ソートのプログラム例を掲載します(やはり Julia で記述してあります)。
a=[9,1,4,3,7,6,2,3]

count = zeros(Int, 9) # 9個箱を用意

for i in a  # 並びから値を順に取り出してカウント
    count[i] += 1
end

result = Int[]
for i=1:9
    if count[i] > 0
        for j=1:count[i]
          push!(result, i) # カウントの回数値を並べる
        end
    end
end
計数ソートは非常に高速ですが、以下の制限があります。
- 適用可能な場合
-
-
値の範囲が事前にわかっている
-
値の範囲が比較的狭い(例:0-100の整数)
-
メモリに余裕がある
-
- 適用困難な場合
-
-
浮動小数点数(値の範囲が広すぎる)
-
文字列(直接的な範囲指定が困難)
-
32ビット整数全体(\(2^{32}\)、つまり約43億個の箱が必要)
-
このため、実際のプログラミングでは比較ベースの整列アルゴリズムが主流となっています。
2.3. 計算モデル
問題によっては通常のコンピューターではなく量子コンピューターを使うと計算が速くなるかもしれません。そこで、計算量を議論するときには、どのようなコンピューターを用いて計算するかを定めなくてはいけません。これを計算モデルとよびます。
並べ替えの計算モデルに、アナログ世界の物理モデルを持ち込むことも考えられます。たとえば、並びの値と同じ長さの棒を用意します。\(\langle 9,1,4,3,7,6,2,3\rangle\) の例を再度もちいると、値が9には9cmの棒、値1には1cmの棒という具合です。そして、平らなテーブルの上で、8本の棒の束を束ねて揃えます。束の上部に手のひらをあて、手のひらに最初に触れた最も長い棒を抜き取り、順に並べます。これを棒がなくなるまで繰り返すと整列完了です。抜き取る操作だけを数えれば8回です。ただし、棒の準備・長さの精度・最長の棒を取り出す操作の費用を省いています。通常のコンピューターで8ステップで整列できるという意味ではありません。何を1回と数えるかで見積もりが変わる例です。
この章では計算モデルについては詳細には立ち入らず、通常のパソコン(ノイマン型コンピューター)を用いると考えてください。ただし、メモリは無尽蔵に使えるものとします。このような計算モデルとしてランダムアクセス機械(Random Access Machine; RAM)がよく用いられます。ランダムアクセス機械では、メモリ上の値には定数時間(例えば1ステップ)で、アクセスして読み書きができます。
3. 時間計算量
ここからは、アルゴリズムの速さを比べるための「ものさし」を整理します。これまでに見てきた時間計算量の評価について、まとめておきます。
-
入力サイズに対して、アルゴリズムの計算が終了するまでに実行される値の比較等の基本演算の回数を、計算時間を評価する基準に用いる
-
入力サイズの増加に対して計算時間がどれだけ増加するかを評価する
-
この章では主に、同じサイズの入力の中でもっとも時間がかかる最悪の場合を評価する(時間計算量には最良・平均などの評価もある)
我々が時間計算量で興味があるのは、入力サイズの増加に対する時間計算量の増加の度合いです。そこで、増加に最も寄与する項だけを残し、それ以外の項や定数の係数は無視して単純化します。たとえば \(T(n)=\frac12n^2-\frac12n\) は \(T(n)=\text O(n^2)\) と表記します。このような表記法をビッグオー表記(O記法)またはオーダー表記といいます。係数と小さい項を捨ててよい理由は、次の節で説明します。
時間計算量を考える場合には、挿入ソートのグラフで見たように、次の3つのケースが考えられます。
- 最悪計算量
-
サイズ \(n\) の入力の中で、もっとも時間のかかるケースを計算量とする
- 最良計算量
-
サイズ \(n\) の入力の中で、もっとも時間のかからないケースを計算量とする
- 平均計算量
-
サイズ \(n\) の入力がどの確率で現れるかを定め、その分布に従う計算時間の期待値を求める。すべての入力が同じ確率なら単純な平均になる
問題そのものが持つ難しさを検討する際には最悪計算量が最も一般的に用いられる指標です。
3.1. ビッグオー表記の考え方
計算量の比較で本当に知りたいのは、「入力が大きくなったとき、計算時間がどんな勢いで増えてゆくか」です。手がかりになるのが、「\(n\) を2倍にしたら、何倍になるか」という問いです。
挿入ソートの最悪の比較回数 \(\frac12n^2-\frac12n\) は、\(n\) が2倍になるとほぼ4倍になりました。係数を変えた \(100n^2\) でも、\(n\) を2倍にすれば \(100(2n)^2=4\times100n^2\) で、やはり4倍です。一方、挿入ソートの最良の場合の \(n-1\) 回のように \(n\) に比例する回数なら、\(n\) を2倍にしても約2倍にしかなりません。この倍率は係数では変わらず、式の中でいちばん勢いよく増える項で決まります。そこで、この勢い(増え方のクセ)だけを取り出すために、ビッグオー表記では思い切って次の2つの情報を捨ててしまいます。
- 定数の係数を捨てる
-
\(\frac12n^2\) でも \(100n^2\) でも、ビッグオー表記ではどちらも \(\text O(n^2)\) です。係数は、使うコンピューターの速さや、1ステップの数え方の違いで変わってしまう量です。速いコンピューターを使えば係数は小さくできますが、増え方のクセそのものは変えられません。
- 低い次数の項を捨てる
-
\(T(n)=\frac12n^2-\frac12n\) では、\(n\) が大きくなるほど \(\frac12n^2\) が圧倒的に大きくなり、\(\frac12n\) の影響は相対的にどんどん小さくなります。そこで、いちばん勢いよく増える項(支配的な項)だけを残します。
この2つを捨てた結果が \(T(n)=\text O(n^2)\) です。「十分大きな入力では、\(n^2\) の定数倍で上から抑えられる」という意味です。上限の評価なので、実際の増え方がもっと遅い関数も含みます。
代表的な関数の増え方を、入力サイズを2倍、10倍にしたときの値で比較してみましょう。次の表は関数そのものの比較です。O記法だけから、実測時間の倍率が決まるわけではありません。
| 関数 \(f(n)\) | \(f(2n)\) は \(f(n)\) と比べて… | \(f(10n)\) は \(f(n)\) と比べて… |
|---|---|---|
\(1\) |
同じ |
同じ |
\(\log_2 n\) |
1増える |
約3.3増える(\(\log_2 10\approx3.32\)) |
\(n\) |
2倍 |
10倍 |
\(n\log_2 n\) |
2倍より少し大きい(\(n=1024\) なら2.2倍) |
10倍より少し大きい(\(n=1000\) なら約13倍) |
\(n^2\) |
4倍 |
100倍 |
\(n^3\) |
8倍 |
1000倍 |
\(2^n\) |
\(2^n\) 倍 |
\(2^{9n}\) 倍(\(n=10\) なら \(2^{90}\) 倍) |
計算時間が \(c n^2\) に近似できる場面では、入力が2倍になると約4倍、10倍になると約100倍の時間がかかると見積もれます。たとえば、ある整列プログラムが \(n=1\) 万個の整列に0.5秒かかり、計算時間が \(cn^2\) で近似できるなら、\(n=10\) 万個では約 \(0.5\times100=50\) 秒かかると見積もれます。これはあくまでモデルによる見積もりで、実際にはメモリの使われ方などによって多少ずれます。次のグラフで関数どうしの増え方を比べてください。
\(n=20\) では、\(\log_2 n\) は約4.3、\(n\log_2 n\) は約86ですが、\(n^2=400\)、\(2^n\) は100万を超えます。
このように、係数と低次の項を無視して増え方だけでざっくり分類することを、入力サイズが十分大きいときの振る舞いに着目するという意味で漸近的に評価するといいます。このように評価した計算量を漸近計算量とよびます。
O は上から抑える評価です。さらに、下から抑える評価を \(\Omega\)(オメガ)、上下から挟んで同程度の増え方を示す評価を \(\Theta\)(シータ)と書きます。厳密な定義は後の折りたたみ欄にまとめています。
「最悪計算量」とO記法を混同しない
ここで、多くの人がつまずくポイントを整理しておきます。「最悪計算量」と「O記法」は、どちらも計算量の話に出てくるためよく混同されますが、別の軸の概念です。
-
軸1(どの入力で測るか): 同じサイズ \(n\) の入力でも、中身によって計算時間は変わります。そこで「最も時間のかかる入力で測る(最悪)」「平均で測る」「最も時間のかからない入力で測る(最良)」のどれかを選びます。どれを選んでも、結果は \(n\) の関数になります。挿入ソートなら、最悪計算量は \(T_{\text{worst}}(n)=\frac{n(n-1)}2\)、最良計算量は \(T_{\text{best}}(n)=n-1\) という関数です。
-
軸2(関数の増え方をどう評価するか): 軸1で得られた関数を、増え方だけに着目して大雑把に評価する「ものさし」がO・Ω・Θです。上からおさえるのがO、下からおさえるのがΩ、上下からはさむのがΘでした。このものさしは、どの関数に対しても使えます。
挿入ソートで確かめてみましょう。最悪計算量 \(\frac{n(n-1)}2\) という1つの関数を、\(\text O(n^2)\) とも \(\Omega(n^2)\) とも \(\Theta(n^2)\) とも評価できます。また、最良計算量 \(n-1\) を \(\text O(n)\) と、Oを使って評価することもできます。
|
「O記法=最悪の場合、Ω記法=最良の場合」という理解は誤りです。最悪・最良は「どの入力で測るか」の選択であり、O・Ωは「得られた関数を上下どちらからおさえるか」の選択です。「挿入ソートは \(\text O(n^2)\) のアルゴリズム」という言い回しは、正確には「挿入ソートの最悪計算量が \(n^2\) の定数倍で上からおさえられる」ことを述べています。 |
これで、計算量を議論するための指標である最悪計算量とビッグオー表記について準備ができました。
次に知っておく必要があるのは、ビッグオー表記による計算量の目安です。以下にビッグオー表記の関数を増加率の小さい順に並べます(ここでは、上界を用います)。これは増え方を比較する目安です。あるアルゴリズムの上界だけで、その問題を解くすべての方法の限界まで決まるわけではありません。
| 名称 | 関数(上界表記) |
|---|---|
定数 |
\(\text O(1)\) |
対数 |
\(\text O(\log n)\) |
線形 |
\(\text O(n)\) |
線形対数(linearithmic) |
\(\text O(n\log n)\) |
2次多項式 |
\(\text O(n^2)\) |
3次多項式 |
\(\text O(n^3)\) |
指数 |
\(\text O(c^n),\quad c>1\) |
階乗 |
\(\text O(n!)\) |
つまり、関数の増え方には次のような順序があります(\(\ll\) は「右の方が圧倒的に速く増える」という意味です)。
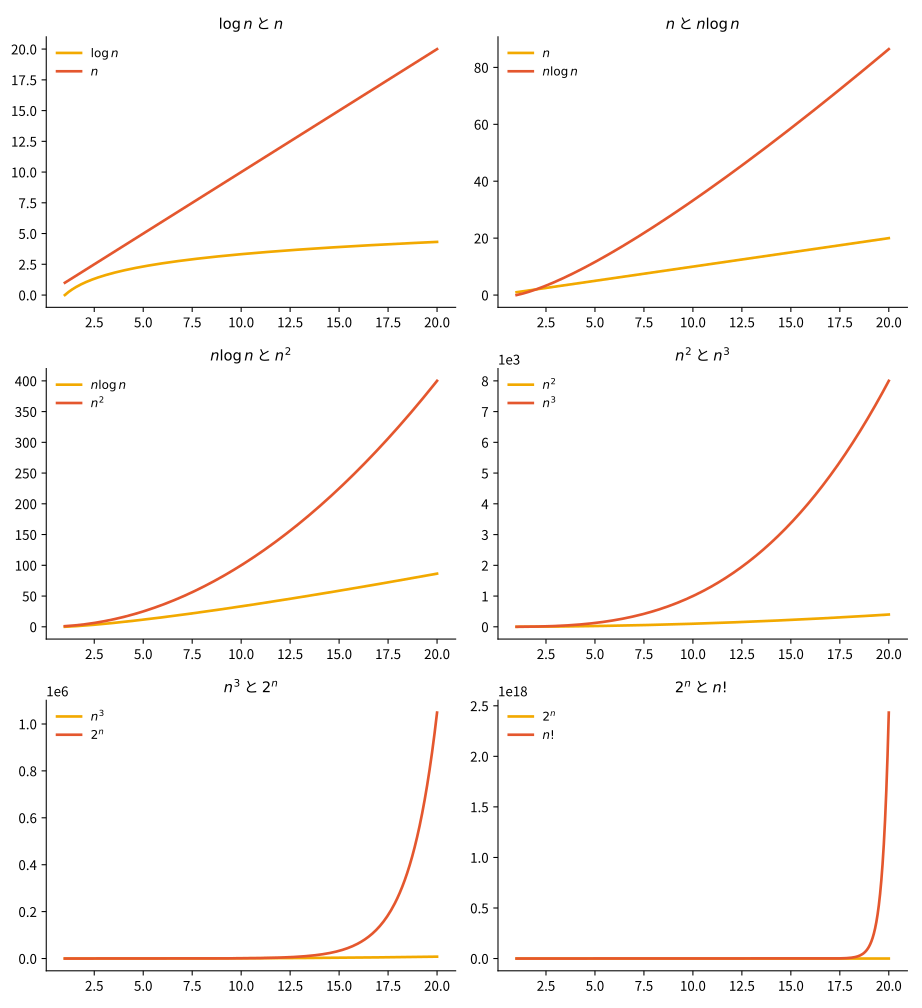
グラフの左上にある「1e3」「1e6」「1e18」は、縦軸の目盛りをそれぞれ \(10^3\)、\(10^6\)、\(10^{18}\) 倍して読むという意味です。ぜひ、Excel等のグラフ描画ツールによって実際に上記の関数のグラフを自分で描いてみて、この順序を実感してみてください。
発展:O・Ω・Θの厳密な定義と計算例(初読では省略可)
上の「ざっくりした増え方」を式で正確に述べると、次のようになります。上からおさえる \(\text O\)、下からおさえる \(\Omega\)、上下からはさむ \(\Theta\) の3つを定義します。
-
表記 \(T(n)=\text O(f(n))\) は 関数 \(c\cdot f(n)\) が \(T(n)\) の上界であることを意味します。つまり、ある正の定数 \(c\) が存在し、十分大きな \(n\) については、常に \(0\leq T(n)\leq c\cdot f(n)\) が成り立ちます。
-
表記 \(T(n)=\Omega(f(n))\) は 関数 \(c'\cdot f(n)\) が \(T(n)\) の下界であることを意味します。つまり、ある正の定数 \(c'\) が存在し、十分大きな \(n\) については、常に \(T(n)\geq c'\cdot f(n)\geq 0\) が成り立ちます。
-
表記 \(T(n)=\Theta(f(n))\) は 関数 \(c\cdot f(n)\) が \(T(n)\) の上界であり、かつ、\(c'\cdot f(n)\) が \(T(n)\) の下界であることを意味します。つまり、ある正の定数 \(c\) と \(c'\) が存在し、十分大きな \(n\) については、常に \(0\leq c'\cdot f(n) \leq T(n)\leq c\cdot f(n)\) が成り立ちます。
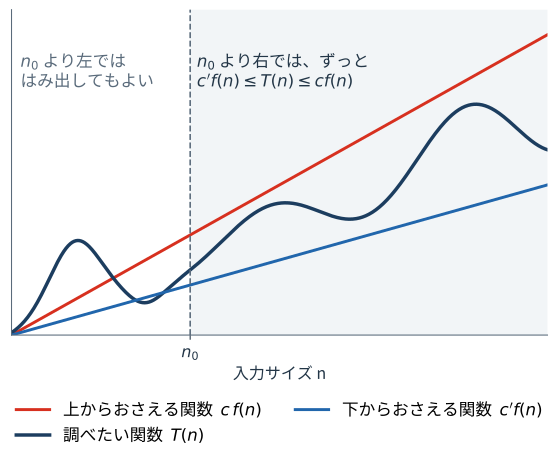
上の図は、ある入力サイズ \(n_0\) より先では、\(T(n)\) が下側の関数 \(c'\cdot f(n)\) と上側の関数 \(c\cdot f(n)\) のあいだにずっとはさまれている様子、つまり \(T(n)=\Theta(f(n))\) を表しています。定義の「十分大きな \(n\) については」は、「ある \(n_0\) があって、\(n\geq n_0\) ならいつでも」という意味です。\(n_0\) より小さい入力では、はみ出していても構いません。先ほどの「だいたい \(n^2\) の勢い」という言い方を、定数 \(c, c'\) で上下からはさむ形に置き換えたものが、この厳密な定義です。
ビッグオー表記は、\(T(n)=\text O(f(n))\) のように等式の形で書きますが、これは慣習による表記であり、実際には左辺と右辺は等しくありません。つまり、\(\text O(f(n))=T(n)\) のような向きでは書きません。\(\text O(f(n))\) は、十分大きな入力で \(f(n)\) の定数倍以下になる関数の集合ですので、本来は \(T(n)\in\text O(f(n))\) と書くのが適当ですが、コンピューター科学分野では慣習として \(T(n)=\text O(f(n))\) という表記を使っています。
上記の定義から、以下の2項目も成り立ちます。
-
\(g(n)=\text O(f(n)) \Leftrightarrow f(n)=\Omega(g(n))\)
-
\(T(n)=\text O(f(n)) \text{ かつ } T(n)=\Omega(f(n)) \;\;\Leftrightarrow\;\; T(n)=\Theta(f(n))\)
-
\(T(n)=2n+5\) の上界
\(n\geq 5\) のとき常に \(2n+5\leq 3n\) となることから、\(T(n)=\text O(n)\)
(ここでは、\(c=3\)) -
\(T(n)=2n+5\) の下界
\(n\geq 0\) のとき常に \(2n+5\geq 2n\) となることから、\(T(n)=\Omega(n)\)
(ここでは、\(c'=2\)) -
よって、\(T(n)=\Theta(n)\)
-
\(T(n)=n^3+10n^2+200n\) の上界
\(n\geq 20\) のとき常に \(n^3+10n^2+200n\leq 2n^3\) となることから、\(T(n)=\text O(n^3)\)
(ここでは、\(c=2\))
ちなみに、値のおさえ方は一通りではありません。以下のように考えても構いません。
-
\(T(n)=n^3+10n^2+200n\)
\(f(n)=211n^3\) とおくと \(n\geq 0\) のとき常に \(T(n)\leq f(n)\) となることから、\(T(n)=\text O(n^3)\)
下界についても同様ですので省略します。
\(\text O(1)\) は、十分に大きな \(n\) については関数の値が、1の定数倍、つまりある定数 \(c>0\) でおさえられるような関数の集合を表しています。
\(T(n)=\text O(n^3)\) のとき、十分大きな \(n\) について(つまり漸近的に) \(T(n)\) を上からおさえられればよいので、\(T(n)=\text O(n^4)\) でも \(T(n)=\text O(n^{10})\) でも \(T(n)=\text O(2^n)\) でもあることに注意をしてください。一般的にはできるだけぎりぎりのところで \(T(n)\) をおさえます。あきらかに \(T(n)=\text O(n^3)\) でおさえられるのであれば、通常は \(T(n)=\text O(n^4)\) とは書きませんが、定義上は間違いではありません。できるだけぎりぎりの関数で評価をすることを「tight に評価する」といいます。
同様に、\(T(n)=\Omega(n^3)\) のとき、漸近的に \(T(n)\) を下からおさえられればよいので、\(T(n)=\Omega(n^2)\) でも \(T(n)=\Omega(n\log n)\) でも \(T(n)=\Omega(1)\) でもあることに注意をしてください。
4. 実用的な整列アルゴリズム
4.1. クイックソート
整列アルゴリズムでもっともポピュラーかつよく使われているのは、クイックソートというアルゴリズムです。最悪時間計算量は \(\text O(n^2)\) ですが、平均時間計算量は \(\text O(n\log n)\) で、しかも後で述べるように基準値(ピボット)をランダムに選べば、\(n\) が大きいときに最悪に近い時間がかかる確率はきわめて小さくなります。
クイックソートを、トランプで説明してみます。
-
山札の中から1枚のカードを適当に抜き出します。
-
抜き出したカードの値が「♠8」だったとします。残りのカードを、8以下の値の左側の山札と、8より大きい値の右側の山札に分けます。
-
分けた2つの山札それぞれで、さらに手順1に戻り、山札のカードが1枚以下になるまで同じことを繰り返します。
最後に、左側の山札、抜き出したカード、右側の山札の順に左から右へつなげてゆくと、整列したカードが得られます。
このように、クイックソートは分割統治法にもとづいています。大きな問題を、基準値(ピボット)を使って2つの小さな問題に分割し、それぞれを再帰的に統治(整列)して、最後に結果を結合します。「再帰的に」とは、分けた小さな問題にも、同じ手順をそのまま使うという意味です。
分割のしくみ
8個の数値 \(\langle 9,1,4,3,7,6,2,3\rangle\) で具体的に見てみましょう。まず基準値を1つ選びます(ここでは説明のため「6」とします。基準値の選び方は後で述べるように性能に影響します)。基準値と比べて、6より小さいグループと6より大きいグループに振り分けます。基準値と等しい値が現れた場合は、基準値と一緒にその位置で確定させます。つまり「基準値より小さい」「基準値と等しい」「基準値より大きい」の3つに分割します。各グループの中では、元の並びの順序を保つことにします。
あとは、左右のグループそれぞれに同じ操作(基準値を選んで分割する)を、グループの要素が1個以下になるまで繰り返すだけです。この分割の繰り返しを木の形で表すと、次のようになります。
各段階での配列の状態をまとめると、次の表のようになります。
段階 |
配列の状態 |
操作 |
|||||||
|---|---|---|---|---|---|---|---|---|---|
0 |
9 |
1 |
4 |
3 |
7 |
6 |
2 |
3 |
初期状態 |
1 |
1 |
4 |
3 |
2 |
3 |
6 |
9 |
7 |
基準値6で分割 |
2a |
1 |
2 |
3 |
3 |
4 |
6 |
9 |
7 |
左側[1,4,3,2,3]を基準値3で分割 |
2b |
1 |
2 |
3 |
3 |
4 |
6 |
7 |
9 |
右側[9,7]を基準値7で分割 |
3a |
1 |
2 |
3 |
3 |
4 |
6 |
7 |
9 |
[1,2]を基準値1で分割 |
最終 |
1 |
2 |
3 |
3 |
4 |
6 |
7 |
9 |
整列完了 |
凡例:緑 = 基準値より小さい、黄 = 基準値と等しい(確定)、赤 = 基準値より大きい、青 = 整列済み
比較回数
各段階での比較回数を数えると、次のようになります。
段階 |
対象配列 |
比較回数 |
説明 |
|---|---|---|---|
1 |
[9,1,4,3,7,6,2,3] |
7回 |
基準値6と他の7個を比較 |
2a |
[1,4,3,2,3] |
4回 |
基準値3と他の4個を比較 |
2b |
[9,7] |
1回 |
基準値7と9を比較 |
3a |
[1,2] |
1回 |
基準値1と2を比較 |
合計 |
13回 |
ここでは、2つの値の大小・等しさを一度で判定する比較を1回と数えて、合計13回です。< と == を別々に評価する実装では、その評価回数は増えます。比較回数を別のアルゴリズムやプログラムと比べるときは、何を1回と数えるかをそろえましょう。
クイックソートの性能
理想的には、基準値が配列をほぼ半分に分けてくれます。すると分割の深さは \(\log_2 n\) 段ほどで、各段で全体をひととおり比較するので約 \(n\) 回、あわせて \(\text O(n\log n)\) になります(下図の左)。これは均等に分割できる場合の説明です。ランダムな基準値を使う場合の期待計算量も同じ評価になりますが、その証明には分割の確率を考える必要があります。
一方、毎回いちばん小さい(または大きい)値を基準値に選んでしまうと、グループが1個ずつしか減らず、深さが \(n\) 段になってしまいます(下図の右)。たとえば、すでに昇順に整列済みの \(\langle 1,2,\ldots,n\rangle\) に対して、いつも先頭を基準値にすると、この最悪の状況が起こります。このときの比較回数は
となり、挿入ソートの最悪の場合と変わらなくなってしまいます。挿入ソートにとっては最良だった整列済みの入力が、この選び方のクイックソートにとっては最悪の入力になるわけです。
値がすべて異なる場合、基準値を一様ランダムに選べば、どの入力に対しても期待時間は \(\text O(n\log n)\) です。3つの値の中央値を使う方法もよく用いられますが、それだけで最悪時間の保証が変わるわけではありません。同じ値が多い入力には、等しい値をまとめる3分割などの工夫が有効です。また、要素数の少ない部分配列では挿入ソートに切り替えると、さらに速くなります。クイックソートが広く使われているのは、平均的にはこの \(\text O(n\log n)\) が達成でき、しかも係数が小さく(実際に速く)、元の配列の中で並べ替える実装ができる(ただし、再帰の管理には追加のメモリを使う)からです。
下に Julia によるクイックソートのプログラムを載せておきます。この例は左右の配列を新しく作るので、元の配列内で並べ替える省メモリの実装とは異なります。アルゴリズムが単純なので(細かい効率を気にしなければ)、すぐに書き下せます(簡単のため、基準値と等しい値を左のグループに入れる2分割版にしてあります。この版では、すべての値が等しい入力で比較回数が \(n^2\) に比例してしまいます)。
function qsort(a)
    n = length(a)  # 山札の数を数える
    if n==0
        []
     else # 山札があるとき
        p = rand(1:n)  # 一枚適当に取り出す
        v = a[p]
        left = []
        right = []
        for i=union(1:p-1,p+1:n) # 抜き取った札を除いて大小関係で左右に分ける
            if a[i] <= v
                push!(left, a[i])
            else
                push!(right, a[i])
            end
        end
        vcat(qsort(left),  [v],  qsort(right)) # 左右の整列結果を結合
    end
end

@show qsort([9, 1, 4, 3, 7, 6, 2, 3]) # 実行
qsort([9, 1, 4, 3, 7, 6, 2, 3]) = Any[1, 2, 3, 3, 4, 6, 7, 9] # 実行結果|
クイックソートは機械翻訳から生まれた
クイックソートを考案したのは、英国の計算機科学者トニー・ホーア(C. A. R. Hoare)です。生まれたきっかけは機械翻訳でした。 ホーア本人の聞き取り記録によると、モスクワ大学への留学中に考えていたのは、ロシア語から英語への機械翻訳でした。当時の辞書は磁気テープにアルファベット順で記録されていたため、文中の単語も先に並べ替えると、テープを一度読むだけでまとめて検索できました。単語ごとにテープを巻き戻す手間を省けたのです。 そこで整列法を考え、最初に思いついたバブルソートは遅そうだと退け、次にクイックソートを考案した、と本人は述べています。「翻訳」という目的から「辞書を効率よく引く」、さらに「単語を並べ替える」へ問題を分けた先に、広く使われるアルゴリズムが生まれました。 |
4.2. マージソート
最悪の場合でも \(\text O(n\log n)\) 回の比較で整列できるアルゴリズムとして、マージソートやヒープソートが知られています。ここではマージソートを紹介します。マージソートも分割統治法にもとづいており、次の2つを組み合わせます。
-
並びを半分に分け、それぞれをマージソートで整列する(半分をさらに半分に……と、1個になるまで分ける。1個の並びは整列済み)
-
整列済みの2つの並びを、1つの整列済みの並びに併合(マージ)する
併合は、2つの並びの先頭どうしを比べて小さい方を取り出す、という操作の繰り返しです。たとえば、整列済みの \(\langle 2,5,8,9\rangle\) と \(\langle 1,3,4,7\rangle\) を併合すると、次のようになります。
| 手順 | 左の残り | 右の残り | 比べる2つ | 取り出す値 | 併合した結果 |
|---|---|---|---|---|---|
1 |
2 5 8 9 |
1 3 4 7 |
2 と 1 |
1 |
1 |
2 |
2 5 8 9 |
3 4 7 |
2 と 3 |
2 |
1 2 |
3 |
5 8 9 |
3 4 7 |
5 と 3 |
3 |
1 2 3 |
4 |
5 8 9 |
4 7 |
5 と 4 |
4 |
1 2 3 4 |
5 |
5 8 9 |
7 |
5 と 7 |
5 |
1 2 3 4 5 |
6 |
8 9 |
7 |
8 と 7 |
7 |
1 2 3 4 5 7 |
7 |
8 9 |
(空) |
比較しない |
8, 9 |
1 2 3 4 5 7 8 9 |
1回の比較で1個ずつ結果が確定し、片方が空になったら残りは比較せずにそのまま後ろにつなげます。そのため、合わせて \(m\) 個の値の併合は、高々 \(m-1\) 回の比較で済みます(この例では8個で6回)。並び \(\langle 9,5,8,2,3,1,7,4\rangle\) を例に、分割から併合までの全体の流れを示すと次の図のようになります(最後の併合が上の表の併合です)。
併合の各段では、全体で \(n\) 個の値を併合するので比較は \(n\) 回未満です。段数は、半分に分けることを繰り返して1個になるまでの約 \(\log_2 n\) 段です。したがって、どんな入力に対しても比較回数は \(n\log_2 n\) 回程度でおさえられ、最悪時間計算量は \(\text O(n\log n)\) です。図の例では、併合の比較回数は \(4+5+6=15\) 回でした。
ちなみに私の手元のノートPCで、ランダムに並んだ1億個の整数をクイックソートで整列させると、計算時間は約6.7秒でした。マージソートでは約9.8秒でした(下の実行結果)。表示されているメモリ量は、sort が整列結果を入れる新しい配列(8バイト × 1億個 = 約763MiB)を含みます。マージソートでは、それに加えて併合の作業用の領域(配列の約半分、約380MiB)を使うため、合計が約1.1GiBになっています。
julia> let n=100000000, x=rand(1:n,n);  @time sort(x, alg=QuickSort); end;
  6.655825 seconds (2 allocations: 762.939 MiB)
julia> let n=100000000, x=rand(1:n,n);  @time sort(x, alg=MergeSort); end;
  9.778350 seconds (4 allocations: 1.118 GiB)
このように、多くの場面でクイックソートの方が速く、作業用のメモリも少なくて済みます。一方、マージソートには、最悪の場合でも \(\text O(n\log n)\) が保証されていることや、安定ソート(後述)であるという利点があります。また、外部ソート(メモリに入りきらない大量のデータを、ハードディスクなどの外部記憶を使ってソートする)に適しています。
4.3. 整列アルゴリズムの比較
クイックソートと挿入ソートの計算量(比較回数)を比較してグラフにしました。入力はランダムな数値の並びです。平均計算量はそれぞれ \(\text O(n\log n)\) と \(\text O(n^2)\) です。入力サイズ \(n\) が大きくなるほど、両者の差が広がってゆくことがわかると思います。\(n=1{,}000\) では、挿入ソートの約25万回に対して、クイックソートは約1.1万回です。
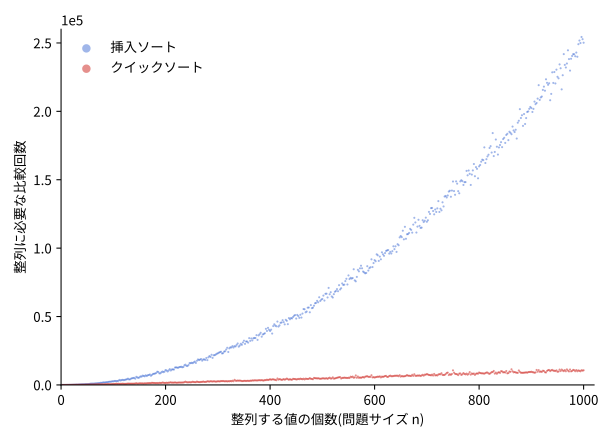
代表的な整列アルゴリズムの計算量を表にまとめます。
| アルゴリズム | 最良時間計算量 | 平均時間計算量 | 最悪時間計算量 | 空間計算量 | 安定性 |
|---|---|---|---|---|---|
挿入ソート |
\(\text O(n)\) |
\(\text O(n^2)\) |
\(\text O(n^2)\) |
\(\text O(1)\) |
安定 |
選択ソート |
\(\text O(n^2)\) |
\(\text O(n^2)\) |
\(\text O(n^2)\) |
\(\text O(1)\) |
不安定 |
バブルソート |
\(\text O(n)\) |
\(\text O(n^2)\) |
\(\text O(n^2)\) |
\(\text O(1)\) |
安定 |
クイックソート |
\(\text O(n\log n)\) |
\(\text O(n\log n)\) |
\(\text O(n^2)\) |
平均 \(\text O(\log n)\)、単純な再帰では最悪 \(\text O(n)\) |
不安定 |
マージソート |
\(\text O(n\log n)\) |
\(\text O(n\log n)\) |
\(\text O(n\log n)\) |
\(\text O(n)\) |
安定 |
ヒープソート |
\(\text O(n\log n)\) |
\(\text O(n\log n)\) |
\(\text O(n\log n)\) |
\(\text O(1)\) |
不安定 |
バブルソートの最良 \(\text O(n)\) は、入れ替えが起きなかったら終了する版の場合です。空間計算量は、入力の配列以外に使う作業用のメモリの量です。
|
安定性とは 同じ値をもつ要素どうしの、元の並び順が整列後も保たれる性質のことです。 たとえば学生の一覧を点数順に整列するとき、同じ点数の学生が何人かいたとします。安定な整列では、その同点の学生たちは元の並び順のまま残ります。不安定な整列では、順序が入れ替わることがあります。まず学年順に並べ、次に点数順に並べる、といった二段階の整列をするときに、この性質が効いてきます。 |
さて、このように優れた整列アルゴリズムが知られているとすると、この章で最初に扱った挿入ソートはお払い箱でしょうか。実用的には問題サイズが小さいときや、もとからほとんどの要素が整列しているとわかっているときには、依然として挿入ソートも用いられます。このような条件下ではクイックソートよりシンプルかつ高速だからです。
実世界での使用例
標準ライブラリでは、用途や実装に応じてさまざまな整列法が使われています。関数名だけからアルゴリズムが決まるとは限りません。
-
C言語:
qsort()は整列関数の名前。規格がクイックソートの使用を指定しているわけではない -
Java:
Arrays.sort()は、数値などの基本型の配列には Dual-Pivot Quicksort(基準値を2つ使う改良版)、オブジェクトの配列には安定な TimSort を使う -
C++:
std::sort()(多くの実装が IntroSort。クイックソートに、分割が深くなりすぎたらヒープソートに切り替える保険を組み合わせたもの) -
Python:
sort()とsorted()は Timsort(マージソートと挿入ソートを組み合わせた安定ソート)。Python 3.11 からは、併合の順序の決め方を Powersort という方式に改良している
|
AIがアルゴリズムを見つける
整列のような基本的なアルゴリズムは、人間が何十年もかけて改良してきました。2023年、Google DeepMind は、囲碁や将棋を攻略した AlphaGo・AlphaZero の強化学習の技術を応用し、「より速い整列の手順を見つけるゲーム」としてこの問題に取り組ませた AlphaDev を発表しました。 AlphaDev が狙ったのは、3〜5個といったごく短い並びを整列する部分です。短い整列は、大きな整列の中で何度も呼び出される基本部品なので、ここが速くなると全体が速くなります。見つかった手順は人間には思いつきにくい命令の並びでしたが、正しく動くことが確かめられ、C++ の標準ライブラリ(LLVM libc++)の整列ルーチンに実際に取り込まれました。この部分の整列の手順が更新されたのは10年以上ぶりで、強化学習で見つけた手順がこのライブラリに採用されたのも初めてのことでした。Google は、このとき改良された整列やハッシュ計算の手順が、世界中で1日に何兆回も使われていると見積もっています。 |
5. 発展:問題そのものの限界
5.1. 問題の最悪時間計算量の上界と下界
さて、整列問題などのコンピューター上で解くべき問題が与えられると、それが重要な問題である場合、研究者はその問題にこぞってとりかかります。プログラマやアルゴリズム開発者は、よりよい高速なアルゴリズムをどんどん開発して、問題の上界(その問題をこの時間で解けることが、実際のアルゴリズムで示されている最悪時間計算量)を改善してゆきます。つまり、最悪時間計算量が既存のアルゴリズムより小さくなるような、新たなアルゴリズムを実際に提示してみせます。たとえば、これまでに知られていた最速のアルゴリズムの時間計算量が \(\text O(n^3)\) だとすると、あらたに、\(\text O(n^2)\) のアルゴリズムが開発できれば改善になります。こうして、研究が進むにしたがって上界をどんどん下にむかっておさえる方向に改善されてゆきます。
一方で、アルゴリズム解析の研究者は、ある問題が与えられたときに、その問題は、この先どれほど素晴らしいアルゴリズムが開発されても、最悪時間計算量が、これ以上は改善できないという下界を上にむかって押し上げる方向で問題に取り組みます。下界を示す際には、実際のアルゴリズムを示すことはまずありません。なぜなら、ある最悪時間計算量のアルゴリズムができるということは、つまり、最悪時間計算量の上界を示すことになるからです。最悪時間計算量の下界の提示は、その下界よりも速い最悪時間計算量のアルゴリズムは存在しないという非存在証明なのです。
いずれにしても、問題の上界と下界は両方とも最悪時間計算量によって考えていることに注意をしてください。
|
用語の整理 \(\text O\), \(\Omega\), \(\Theta\) は、1つの関数 \(T(n)\) の増え方を上下からおさえるための表記です。この節で扱う「問題の最悪時間計算量の下界」(どんなアルゴリズムを設計しても、これより速くは解けないという問題そのものの限界)とは意味が異なりますので、区別してください。ただし、問題の下界を表すときにも \(\Omega\) の記号を使います。たとえば「整列問題の下界は \(\Omega(n\log n)\)」は、「どんな比較ベースのアルゴリズムでも、最悪計算量は \(n\log n\) の定数倍より下にはならない」という意味です。 |
下界証明の準備:なぜ証明が必要か
「もっと速いアルゴリズムがあるかもしれない」という疑問に答えるため、理論的な限界を証明する必要があります。
- 証明のアプローチ
-
-
どんなアルゴリズムでも避けられない「必要最小限の作業量」を見つける
-
その作業量から計算量の下限 「これより速くはできない」量を導く
-
この考え方は、コンピューター科学で「不可能性の証明」を行うときによく使われます。
以下では、具体的に整列問題の最悪時間計算量の下界証明をしてみます。
5.2. 整列問題の下界:結論と証明
比較だけで整列する場合、どんな正しいアルゴリズムでも、最悪の場合には \(\Omega(n\log n)\) 回の比較が必要です。 計数ソートは値を配列の添字に使うので、この「比較だけ」という前提に当てはまりません。
証明の骨格は、\(n!\) 通りの並び方を二択の質問で区別するには、少なくとも \(\log_2(n!)\) 回の質問が必要、というものです。
証明を読む(決定木・階乗・対数を使用。初読では省略可)
【定理】入力の並びに含まれる値の大小比較の情報のみを用いた整列アルゴリズムの最悪時間計算量の下界は、\(\Omega(n\log n)\) である。
つまり、比較に基づく整列問題は、どんなに頑張っても最悪時間計算量を \(n\log n\) のオーダーより改善することは原理的に不可能だという定理です。
まず、\(n\) 個の入力が持ちうる並べ方のバリエーションは、\(n\)個の順列ですので \(n!\) です。たとえば、3個のキー cat, dog, rat の並べ方は、3の階乗(\({}_3P_3=3!=6\))個あります。
-
\(s_1=\langle\text{cat},\text{dog},\text{rat}\rangle\)
-
\(s_2=\langle\text{cat},\text{rat},\text{dog}\rangle\)
-
\(s_3=\langle\text{dog},\text{cat},\text{rat}\rangle\)
-
\(s_4=\langle\text{dog},\text{rat},\text{cat}\rangle\)
-
\(s_5=\langle\text{rat},\text{cat},\text{dog}\rangle\)
-
\(s_6=\langle\text{rat},\text{dog},\text{cat}\rangle\)
整列アルゴリズムは、このいずれの入力にも対応していなければなりません。つまり、\(n!\) 種類の入力に対応する必要があるわけです。ここで、入力の並びに含まれる値はすべて異なると仮定しています。最悪時間計算量を考える際には、この仮定をしておけば十分だからです(同じ値が存在すれば、入力の組合せの数は減るだけです)。
あらゆる入力を大小関係の比較情報のみで整列するには、大小比較で生じる場合分けを分岐点とする下図の例ような木を考えればいいことがわかります。この例では、入力に含まれる値の数は \(n=3\) です。

図の丸い角の箱が1回の比較で、その答え(yes/no)によって左右に分かれます。一番下の四角い箱(葉)は、たどり着いたときに確定する並べ方です。6通りの並べ方すべてに対応する葉があります。
整列アルゴリズムを実行するときには、この木のうち、どこか1つの根から葉への経路をたどることになります。経路の長さ(たどった分岐の数)が、その入力に対する比較回数です。したがって、根から最も深い葉までの段数、つまり木の高さ \(h\) が、最悪の場合の比較回数に対応します。
木の段数が1段増えると、対応できる入力の種類は高々2倍になります。よって、\(h\) 回の比較では、高々 \(2^h\) 種類の入力列の仕分け(ここでは整列)ができることになります。つまり、高々 \(2^h\) 個の順列を整列できることになります。実際に整列できるようにしたいのは、入力として想定される \(n!\) 個の順列です。つまり、\(n!\) 個の順列を十分に仕分けできるだけの比較回数 \(h\) を与えるには、
である必要があります。たとえば \(n=3\) なら \(2^h\geq 6\) から \(h\geq 3\) で、上の図の木の高さ3は、これ以上低くできないことがわかります。
ここで、以下の不等式を証明しておきましょう。
【証明】\(n\geq 1\) と仮定してよいから、両辺を2乗した以下の不等式を証明すれば良い。
左辺に着目すると…
最後の不等式は以下の事実より直ちに導かれます。\(f(k)=k\cdot((n+1)-k)=-k^2+kn+k\) は、\(1\leq k\leq n\) の範囲で変化し、上に凸な二次関数なので、\(k=1\) または \(k=n\) で最小値をとります。\(f(1)=f(n)=n\) より、\(f(k)=k\cdot((n+1)-k)\geq n\) が成り立ちます。
よって、
が成り立ちます。底が2の対数は単調増加関数ですから、両辺に対数を適用すると
よって、
となり、比較回数\(h\) を時間計算量としたときの下界が証明できました。対数の底は、定数倍の違いしかないので、計算量を考える際には重要ではないことに注意してください(ただし、底は1より大きいことを仮定します)。
この証明は、具体的な整列アルゴリズムを示していません。比較のみに基づく限りは、\(n\log n\) のオーダーより速いアルゴリズムは存在しないという非存在証明になっています。
また、この証明は情報理論的証明と呼ばれます。\(n!\) 個の順列のうちから1つの整列された値の列を特定するには、\(\log_2(n!)\) ビットの情報が必要です。ここで使った大小の二択の比較は、決定木を高々2つに枝分かれさせます。そのため、深さ h で区別できる場合の数は高々 \(2^h\) 通りです(個々の珍しい結果の自己情報量が必ず1ビット以下、という意味ではありません)。比較回数を \(h\) としたとき、比較によって元の順列がもつ以上の情報量を得なくてはならないため \(h\geq \log_2(n!)\) である必要があるからです。
5.3. 最適時間計算量
前節では、比較のみを用いた整列問題の時間計算量の下界が \(\Omega(n\log n)\) であることを証明しました。実は、整列問題では、マージソートやヒープソート等の具体的なアルゴリズムとして、上界が \(\text O(n\log n)\) であるアルゴリズムがすでに開発されています。つまり、下界と上界が一致しているのです。この場合の計算量は、上界と下界で抑えられているので \(\Theta(n\log n)\) と表記できます。これを、最適時間計算量とよび、これ以上は(定数倍等の要素を除き)アルゴリズムは改善できず、最も時間効率の良いアルゴリズムにたどり着いたことになります。くどいようですが、これは最悪時間計算量の観点からこれ以上改善できない最適なアルゴリズムが存在するということです。挿入ソートアルゴリズムは、もともと整列された入力データでは最良時間計算量 \(\text O(n)\) で計算できることを思い出してください。
整列問題は幸運な例ですが、世の中には、時間計算量の上界と下界が一致していない問題はたくさんありますので、アルゴリズム研究もまだまだ続くことになります。また、整列問題も、具体的に取り組んでいる問題によっては「値の情報として比較のみを用いる」という条件を緩和することができるかもしれませんので、もっと効率の良いアルゴリズムが設計できるかもしれません。
このあたりのせめぎあいを図にしてみました。

最適時間計算量が知られていない問題はたくさんあります。たとえば、行列の掛け算問題の時間計算量は、既知の下界 \(\Omega(n^2)\) に対して、よく知られたStrassenのアルゴリズムでも上界 \(\text O(n^{\log_2 7})\)(約 \(\text O(n^{2.8074})\))が得られます。その後も指数を小さくする研究が続き、2020年代には指数は約2.37まで下がっていますが、下界の \(n^2\) との差は埋まっていません。ここでは通常の算術演算を1回と数えるモデルを考えています。
実は理論上最速のアルゴリズムが、実際にプログラムを書いてみると最速であるというわけではありません。たとえば行列の掛け算では、行列の規模・メモリの使い方・並列化によって、演算回数が \(\text O(n^3)\) のよく最適化された実装のほうが速い場合があります。現実には、実際に扱う問題の入力サイズの規模で効率の良いアルゴリズムを選択したり、実装がシンプルでバグが混入しにくければ、多少遅くてもシンプルなアルゴリズムを選んだ方が良いということはよくあります。
|
コラム: 実用にならない改善に、なぜ意味があるのか
現実の計算時間の改善に結びつかないのなら、漸近的計算量の改善の追求は無意味なのでしょうか。そうではありません。 行列の掛け算が \(\text O(n^3)\) より速くできることを最初に示したのはシュトラッセン(1969年)でした。鍵になったのは「2×2の行列の積は、8回ではなく7回の掛け算で計算できる」という代数的な工夫です。大きな行列を2×2のブロックに区切ってこの工夫を再帰的に使うと、掛け算の回数が \(n^3\) ではなく \(n^{\log_2 7}\) に比例するようになります。誰もが当たり前と思っていた計算に、実は無駄が潜んでいたのです。新しい上界の証明は、このように問題に隠れていた構造を見つけ出すことでもあります。以後の上界の改善競争は、速さの競争であると同時に、「行列の積とは何か」の理解を深める研究でもあります。 その理解がどこまで進んだかを測る目盛りが、上界と下界のギャップです。整列問題のように上下界が \(\Theta(n\log n)\) で一致すれば、問題の難しさの正体はそこで確定します。行列の掛け算では、知られている上界と下界にまだギャップが残っていますが、これは「本当は \(n^2\) に近い速さで掛けられるのか、それとも \(n^2\) では掛けられない本質的な理由があるのか」という問いが未解決だということです。ギャップを詰める研究は、この問いに答えようとする研究だといえます。 こうして得られた理論的な知見は、しばしば時間差で、あるいは別の場所で実を結びます。素数判定のAKSアルゴリズム(2002年)は、実用速度では従来の確率的アルゴリズムに及びませんが、「素数判定は、乱数を使わない多項式時間のアルゴリズムで解ける(第12章で扱う「P問題」に属する)」ことを確定させ、この問題の理論上の位置づけをはっきりさせました。漸近的改善のために開発された証明技法やデータ構造が、後に別の問題で実用的なアルゴリズムを生むことも珍しくありません。漸近的計算量の研究は、個々のプログラムの速度改善というより、「計算という現象の地図」を描く基礎研究なのです。 |
6. 練習問題
基本の確認から始め、手作業での実行と計算の練習、考える問題の順に並べています。まず自分で解いてから、解答を開いて確かめてください。
挿入ソートで以下の整数の並びを整列するとき、整列に必要な比較回数を求めよ。比較回数は、本文の図と同じく、挿入する値と整列済みの部分の値を比べた回数とする。
解答
9回です。各段階の並び(太字が挿入した値)と比較回数は次のとおりです。
| 挿入する値 | 挿入後の並び | 比較回数 |
|---|---|---|
3 |
3 5 1 2 8 6 |
1(5と比べる) |
1 |
1 3 5 2 8 6 |
2(5, 3と比べる) |
2 |
1 2 3 5 8 6 |
3(5, 3, 1と比べる) |
8 |
1 2 3 5 8 6 |
1(5と比べる) |
6 |
1 2 3 5 6 8 |
2(8, 5と比べる) |
合計 |
9 |
挿入する値より大きい値に出会う間は右へずらし続け、自分以下の値に出会ったらその比較で止まります。止めた値との比較も1回に数えることに注意してください(2を挿入するときは、最後に1と比べて止まるので3回)。一方、先頭まで達した場合(1を挿入するとき)は、止める値がないので、その分の比較はありません。
参考として、6個の並びでは、最悪の場合(降順)は \(1+2+3+4+5=15\) 回、最良の場合(昇順)は5回です。
問題1と同じ並び \(\langle5,3,1,2,8,6\rangle\) について、次の問いに答えよ。
-
選択ソートで整列するとき、各段階(最小値を選んで入れ替えた後)の並びを書き、比較回数の合計を求めよ。
-
バブルソート(入れ替えが1回も起きないパスがあったら終了する版)で整列するとき、各パスの後の並びと、各パスの比較回数・入れ替えの回数を書き、比較回数の合計を求めよ。
解答
-
選択ソート: 比較回数は15回です。
段階 選んだ最小値 入れ替えた後の並び 比較回数 1
1(5と入れ替え)
1 3 5 2 8 6
5
2
2(3と入れ替え)
1 2 5 3 8 6
4
3
3(5と入れ替え)
1 2 3 5 8 6
3
4
5(そのまま)
1 2 3 5 8 6
2
5
6(8と入れ替え)
1 2 3 5 6 8
1
合計
15
最小値を探すには残りをすべて調べる必要があるので、比較回数は入力によらず \(5+4+3+2+1=15\) 回です。段階3の後にはすでに整列が終わっていますが、選択ソートはそれを判定しないので、最後まで比較を続けます。
-
バブルソート: 比較回数は12回です。
パス パスの後の並び 比較回数 入れ替えの回数 1
3 1 2 5 6 8
5
4
2
1 2 3 5 6 8
4
2
3
1 2 3 5 6 8
3
0
合計
12
パス1では、5が3, 1, 2と順に入れ替わって右へ進み、8と比べて止まります(入れ替えない)。最後に8と6が入れ替わり、最大の8が右端で確定します。パス2の後に整列は終わっていますが、それはパス3で入れ替えが起きないことを確かめて初めてわかります。
同じ入力でも、挿入ソート9回、バブルソート12回、選択ソート15回と、比較回数はアルゴリズムによって違います。
各グループの先頭の値を基準値に選び、本文と同じく「基準値より小さい」「基準値と等しい」「基準値より大きい」の3つに分けるクイックソートを考える(各グループの中では元の順序を保つ)。比較は、基準値と他の値を1回比べるごとに1回と数える。
-
並び \(\langle4,2,7,1,5,3\rangle\) を整列するときの分割の様子(再帰木)を書き、比較回数の合計を求めよ。
-
すでに整列済みの並び \(\langle1,2,3,4,5,6\rangle\) を整列するときの比較回数の合計を求め、1.と比べて多くなる理由を説明せよ。
解答
-
比較回数は8回です。
対象のグループ 基準値 分割の結果(小さい / 等しい / 大きい) 比較回数 [4,2,7,1,5,3]
4
[2,1,3] / {4} / [7,5]
5
[2,1,3]
2
[1] / {2} / [3]
2
[7,5]
7
[5] / {7} / [ ]
1
合計
8
要素が1個以下のグループ([1], [3], [5], [ ])は、それ以上分割しないので比較はありません。確定した値を左からつなげると 1 2 3 4 5 7 になります。
-
比較回数は \(5+4+3+2+1=15\) 回です。先頭の値が毎回そのグループの最小値なので、「小さい」グループは空になり、「大きい」グループには残りがすべて入ります。1回の分割で1個しか確定しないため、分割が5段必要になり、各段の比較回数が1ずつしか減りません。本文の図の右側(偏った分割)の状況で、比較回数は \(\frac{n(n-1)}2\) になります。1.では基準値4がグループをほぼ半分ずつ(3個と2個)に分けたので、比較回数が少なく済みました。この問題を避けるには、基準値をランダムに選ぶなどの工夫をします。
値の範囲が1から5までであることがわかっている並び \(\langle3,1,4,1,5,2,5\rangle\) を、計数ソートで整列する。
-
値1〜5の箱のカウントを、並びをすべて読み終えた時点で答えよ。
-
整列の結果を書け。また、この整列の途中で値どうしの比較を何回行ったか答えよ。
-
64ビットの整数(約 \(1.8\times10^{19}\) 通りの値をとりうる)を、値の範囲について何もわからないまま計数ソートで整列するのが現実的でない理由を説明せよ。
解答
-
値1から5の順に \((2,1,1,1,2)\) です(1と5が2個ずつ、2, 3, 4が1個ずつ)。
-
1 1 2 3 4 5 5 です。値どうしの比較は0回です。計数ソートは、値を箱の番号として使って数えるだけで、2つの値の大小を比べることはありません。そのため、比較だけを使う整列の下界 \(\Omega(n\log n)\) の対象外です。
-
箱を値の範囲の数(\(2^{64}\approx1.8\times10^{19}\) 個)だけ用意する必要があるからです。箱1個に1バイトしか使わないとしても約 \(1.8\times10^{19}\) バイト(約1800万テラバイト)が必要で、どんなコンピューターのメモリにも入りません。また、箱を初期化して順に調べるだけで \(k\) に比例する膨大な時間がかかります。計数ソートの時間 \(\Theta(n+k)\) は、値の範囲 \(k\) が狭いときにだけ速いのです。
次の問いに答えよ。ただし、計算時間は与えられた式の定数倍でよく近似できるものとする。
-
計算時間が \(n\)、\(n^2\)、\(n^3\)、\(2^n\) にそれぞれ比例するアルゴリズムがある。入力サイズ \(n\) を2倍にすると、計算時間はそれぞれ約何倍になるか。
-
計算時間が \(n^2\) に比例する整列プログラムが、\(n=1\) 万個の整列に0.5秒かかった。\(n=10\) 万個、\(n=100\) 万個ではそれぞれ約何秒かかるか。
-
計算時間が \(n^3\) に比例するプログラムが、\(n=100\) で1秒かかった。\(n=1000\) では約何秒か。
-
計算時間が \(n\log_2 n\) に比例する整列プログラムが、\(n=10\) 万個の整列に0.2秒かかった。\(n=100\) 万個では約何秒か。
解答
-
\(n\) は2倍、\(n^2\) は4倍、\(n^3\) は8倍です。\(2^n\) は \(2^{2n}=2^n\times2^n\) なので \(2^n\) 倍になり、元の \(n\) によって倍率そのものが変わります(\(n=30\) なら約10億倍)。
-
\(n\) が10倍になると時間は \(10^2=100\) 倍なので、10万個では約 \(0.5\times100=50\) 秒です。100万個はさらに10倍なので、約 \(50\times100=5000\) 秒(約1時間23分)です。
-
\(n\) が10倍なので、時間は \(10^3=1000\) 倍の約1000秒(約17分)です。
-
時間の比は
\[\frac{10^6\log_2 10^6}{10^5\log_2 10^5}=10\times\frac{6\log_2 10}{5\log_2 10}=10\times1.2=12\]なので、約 \(0.2\times12=2.4\) 秒です。\(n\log n\) の場合、\(n\) が10倍になっても時間は10倍より少し多いだけで済みます。対数の底は比の計算では打ち消し合うので、\(\log_{10}\) で計算しても同じ結果になります。2.と比べると、\(n^2\) と \(n\log n\) の差が、\(n\) が大きいほど開くことがわかります。
あるアルゴリズムの時間計算量が入力サイズ \(n\geq 1\) に対して \(T(n)=6n^3+9n^2+28\) であるとき、以下の選択肢から正しいものをすべて選べ(正しいものが1つもない可能性も、2つ以上ある可能性もある)。
-
\(T(n)=\text O(n)\)
-
\(T(n)=\Omega(n\log n)\)
-
\(T(n)=\Theta(n^2)\)
-
\(T(n)=\text O(n^2)\)
-
\(T(n)=\text O(n^3)\)
-
\(T(n)=\Omega(n^3)\)
-
\(T(n)=\text O(n^4)\)
-
\(T(n)=\Omega(n^4)\)
解答
正しいのは b, e, f, g です。
\(T(n)\) では最も次数の高い項 \(6n^3\) が増え方を支配しているので、\(T(n)=\Theta(n^3)\) です。実際、\(n\geq1\) では
なので、\(c'=6\)、\(c=43\) として上下からはさめます。関数の増え方の順序
を踏まえると、次のように判定できます。
-
O(上からおさえる)は、\(n^3\) と同じか、それより速く増える関数なら成り立ちます。よって e(\(n^3\))と g(\(n^4\))は正しく、a(\(n\))と d(\(n^2\))は誤りです。
-
Ω(下からおさえる)は、\(n^3\) と同じか、それより遅く増える関数なら成り立ちます。よって b(\(n\log n\))と f(\(n^3\))は正しく、h(\(n^4\))は誤りです。
-
Θ(上下からはさむ)は、増え方が同じ関数でなければ成り立ちません。c(\(n^2\))は誤りです。
g のように「定義上は正しいが、ぎりぎりの評価ではない」ものも正解に含まれる点に注意してください。
次の文のそれぞれについて、正しいか誤りかを答え、理由を説明せよ。
-
挿入ソートの最良計算量は \(\text O(n)\) である。
-
O記法は、最悪の場合の計算量を表すための記法である。
-
選択ソートの最良計算量は \(\Theta(n^2)\) である。
-
クイックソート(基準値を毎回先頭の値にする版)の最悪計算量は \(\text O(n\log n)\) である。
-
マージソートの最悪計算量は \(\text O(n^2)\) である。
解答
-
正しい。挿入ソートの最良計算量は \(n-1\) 回で、\(n\) の定数倍で上からおさえられます。O記法は最悪計算量以外の関数にも使えます。
-
誤り。O記法は、ある関数を上からおさえるための記法で、最悪・最良・平均のどの計算量にも使えます。「どの入力で測るか」(最悪・最良・平均)と「得られた関数をどうおさえるか」(O・Ω・Θ)は別の軸です。
-
正しい。選択ソートは入力によらず常に \(\frac{n(n-1)}2\) 回比較するので、最良の場合でも \(n^2\) の定数倍で上下からはさめます。
-
誤り。整列済みの入力で比較回数が \(\frac{n(n-1)}2\) 回になり、これは \(n\log n\) の定数倍では上からおさえられません(\(n\log n\) より速く増えます)。最悪計算量は \(\Theta(n^2)\) です。
-
正しい。マージソートの最悪計算量は \(n\log n\) 程度で、\(n^2\) の定数倍で上からおさえられます。ただし、ぎりぎりの評価(\(\text O(n\log n)\))ではないので、通常はこうは書きません。
値がすべて異なる5個の並びを、値どうしの比較だけを使って整列するアルゴリズムを考える。
-
どんなアルゴリズムでも、最悪の場合に少なくとも何回の比較が必要か。本文の決定木の考え方を使って求めよ。
-
挿入ソートの最悪の比較回数は何回か。1.の答えと比べよ。
-
計数ソートは、値の範囲が狭ければ \(n\log n\) より少ない手間で整列できる。これは本文で証明した下界と矛盾しないか。
解答
-
7回です。5個の並べ方は \(5!=120\) 通りあり、\(h\) 回の比較で区別できるのは高々 \(2^h\) 通りなので、\(2^h\geq120\) が必要です。\(2^6=64<120\leq128=2^7\) より、\(h\geq7\) です(\(\log_2 120\approx6.91\) を切り上げた値)。
-
\(1+2+3+4=10\) 回です。下界の7回より多く、改善の余地があります。実際、5個の値を最悪でも7回の比較で整列する手順が知られているので、5個の場合はこの下界がぎりぎりの値です。参考までに、半分に分けるマージソートの最悪は8回です。
-
矛盾しません。本文の下界は「値どうしの比較だけを使う」アルゴリズムについての定理です。計数ソートは値を箱の番号として使い、比較をまったく行わないので、この定理の前提に当てはまりません。前提を満たさないアルゴリズムには、定理の結論は適用されません。