1. 情報理論の誕生
1948年、ベル研究所のクロード・シャノンは論文「通信の数学的理論」を発表しました。この論文でシャノンは、それまで漠然とした概念だった「情報」を確率と対数によって定量化し、そのうえで
-
データはどこまで圧縮できるか(情報源符号化定理)
-
ノイズのある通信路でどこまで正確に情報を送れるか(通信路符号化定理)
という2つの根本的な問いに、理論的な限界を与えて一挙に答えてしまいました。データ圧縮、通信、記録媒体など、現在のデジタル技術の多くがこの理論を出発点にしています。
本章では、この2つの定理を目標に情報理論を概観します。定理の証明や厳密な理論展開には立ち入りません。本格的に学びたい人は情報理論の専門書(たとえば Cover & Thomas, Elements of Information Theory)にあたってください。
2. 符号化とデータ圧縮
2.1. 符号
テキスト、画像、音声などのデータをコンピューターで扱うには、\(\TT 0\) と \(\TT 1\) の並びに変換する必要があります。この変換の規則を符号、変換の操作を符号化とよびます。変換前の記号を情報源記号、変換後の記号を符号記号とよび、情報源記号1つに割り当てられる符号記号の並びを符号語とよびます。同様に、変換前後の記号の並びをそれぞれ情報源記号列、符号記号列とよびます。
たとえば、新型コロナウイルスのゲノム配列に現れる4種類の記号 \(\TT A, \TT C, \TT U, \TT G\) は、次の符号 \(C_a\) でビット列に変換できます。
| 情報源記号 | \(\TT A\) | \(\TT C\) | \(\TT U\) | \(\TT G\) |
|---|---|---|---|---|
符号語 |
\(\TT{00}\) |
\(\TT{01}\) |
\(\TT{10}\) |
\(\TT{11}\) |
符号 \(C_a\) で記号列 \(\TT{ACACGU}\) を変換すると、次の図のようになります。
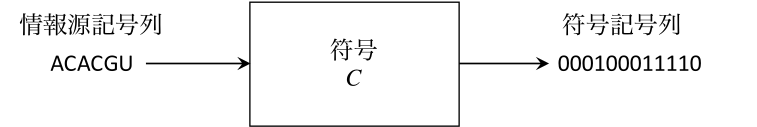
このように各記号に同じ長さの符号語を割り当てた符号を固定長符号といいます。文字コードの章で学んだASCIIも7ビットの固定長符号です。記号 \(x\) の符号語を \(C(x)\)、その長さ(符号語長)を \(|C(x)|\) と表します。記号列の符号化は、各記号の符号語を順につなげるだけです。記号列 \(x_1 x_2\cdots x_k\) を符号化して得られる符号記号列を \(C^+(x_1 x_2\cdots x_k)=C(x_1)C(x_2)\cdots C(x_k)\) と書きます。
2.2. 頻度の高い記号に短い符号語を — 可変長符号
1830年代に生まれたモールス符号では、英語で最も頻度の高い \(\TT E\) に最短の符号語「・」が割り当てられています。頻度の高い記号に短い符号語を与えれば、全体の長さは短くなる——これがモールス以来のデータ圧縮の基本原理です。記号ごとに符号語の長さが異なる符号を可変長符号といいます。
10文字の記号列 \(\TT{ACAAUAACAG}\) で試してみます。この記号列では \(\TT A\) が6回と多く出現するので、\(\TT A\) に短い符号語を割り当てる次の符号 \(C_b\) を考えます。
| 記号 | \(\TT A\) | \(\TT C\) | \(\TT U\) | \(\TT G\) |
|---|---|---|---|---|
符号語 |
\(\TT 0\) |
\(\TT{10}\) |
\(\TT{110}\) |
\(\TT{111}\) |
固定長符号 \(C_a\) では20ビットだったものが16ビットになりました。情報源記号1つあたりに換算すると、記号列の平均符号語長は2ビットから16/10=1.6ビットに短くなっています。
2.3. 可変長符号の落とし穴 — 一意復号と瞬時符号
可変長符号では、符号記号列のどこが符号語の切れ目かがわからなくなるという問題が生じます。モールス符号は符号語の間に時間的な間を入れて切れ目を表していますが、これは切れ目のための第3の記号を追加していることに他ならず、その分データ量が増えます。切れ目の記号なしで復号できる符号はどのようなものでしょうか。次の2つの符号を見てください。
| 記号 \(x\) | 符号語 \(C_1(x)\) | 符号語 \(C_2(x)\) |
|---|---|---|
\(\TT a\) |
\(\TT{0}\) |
\(\TT{0}\) |
\(\TT b\) |
\(\TT{100}\) |
\(\TT{11}\) |
\(\TT c\) |
\(\TT{11}\) |
\(\TT{100}\) |
\(\TT d\) |
\(\TT{101}\) |
\(\TT{01}\) |
符号 \(C_2\) で符号記号列 \(\TT{01001111000}\) を復号してみると、
-
\(\uB{01}{d}\uB{0}{a}\uB{01}{d}\uB{11}{b}\uB{100}{c}\uB{0}{a}\) より \(\TT{dadbca}\)
-
\(\uB0a\uB{100}c\uB{11}b\uB{11}b\uB0a\uB0a\uB0a\) より \(\TT{acbbaaa}\)
と、少なくとも二通りに復号できてしまいます。どの符号記号列も高々一通りにしか復号できない符号を一意復号可能な符号といいます。\(C_2\) は一意復号可能でない符号であり、実用には使えません。
一方、符号 \(C_1\) で \(\TT{1000100110101}\) を復号すると、
-
\(\uB{100}b\uB0a\uB{100}b\uB{11}c\uB0a\uB{101}d\)
のように、左から読み進めるだけで、先読みも後戻りもせずに記号を確定してゆけます。このような符号を瞬時符号といいます。瞬時符号であるための条件は簡単で、
どの符号語も、他の符号語の先頭部分(語頭、プレフィックス)になっていない
ことです(語頭条件)。\(C_2\) では \(C_2(\TT a)=\TT 0\) が \(C_2(\TT d)=\TT{01}\) の語頭になっているのに対し、\(C_1\) はどの符号語も他の符号語の語頭になっていません。
この条件は、符号を符号木という木構造で表すとよく見えます。根から葉に向かって辺をたどり、分岐の上側を \(\TT 0\)、下側を \(\TT 1\) と読むと、根からの経路が符号語に対応します。語頭条件は「すべての記号が葉に配置されている」ことと同じです。
\(C_2\) では記号 \(\TT a\) が葉ではなく途中のノードにあるため、\(\TT 0\) を読んだ時点で「\(\TT a\) で確定」か「\(\TT d\) の途中」かが区別できません。瞬時符号なら、葉に到達するたびに記号を1つ確定して根に戻る、という機械的な操作で復号できます。
2.4. ハフマン符号
では、瞬時符号の中で平均符号語長を最小にするには、どのように符号語を割り当てればよいのでしょうか。この問題を解くのがハフマン符号です。アルゴリズムはとても単純です。
-
各記号の出現頻度(または生起確率)を求め、記号ごとにノードを作る
-
頻度の最も小さい2つのノードをまとめて新しいノードを作り、頻度の和をその頻度とする
-
すべてが1つの木にまとまるまで2.を繰り返す
-
各分岐の2本の辺に \(\TT 0\) と \(\TT 1\) を割り当て、根から葉までの経路を符号語とする
記号列 \(\TT{cbaccbcdacadbbc}\)(15文字)で試してみます。頻度は次のとおりです。
| 記号 | \(\TT a\) | \(\TT b\) | \(\TT c\) | \(\TT d\) |
|---|---|---|---|---|
頻度 |
3 |
4 |
6 |
2 |
まず最小の \(\TT d\)(2)と \(\TT a\)(3)をまとめて頻度5のノードを作ります。次に残りの中で最小の \(\TT b\)(4)と今作ったノード(5)をまとめて頻度9のノードを、最後に \(\TT c\)(6)と(9)をまとめて根を作ります。分岐の上側の辺に \(\TT 0\)、下側に \(\TT 1\) を割り振ると、根から各葉までの辺の数字を並べたものが符号語になります。この手順を図にすると次のとおりです。
葉の側から根に向かって木を組み立てていくので、頻度の小さい記号ほど根から遠く、つまり長い符号語になります。
| 記号 | \(\TT a\) | \(\TT b\) | \(\TT c\) | \(\TT d\) |
|---|---|---|---|---|
符号語 |
\(\TT{000}\) |
\(\TT{01}\) |
\(\TT{1}\) |
\(\TT{001}\) |
作り方から、すべての記号は葉に配置されるので、ハフマン符号はつねに瞬時符号です。元の記号列を符号化したときの長さは、各記号の(出現回数)×(符号語長)の合計で
となり、平均符号語長は29/15≈1.93ビットです(2ビットの固定長符号より短くなりました)。
ハフマン符号は一通りには決まりません。\(\TT 0\) と \(\TT 1\) の割り振り方を変えても各記号の符号語長は変わりません。また、頻度の同じノードが複数あるときはどれを選んでもよく、選び方によって符号語長の組が変わることもありますが、平均符号語長はどれも同じ最小値になります。
そして、ハフマン符号については次のことが証明されています(証明は専門書に譲ります)。
記号ごとに符号語を割り当てる瞬時符号の中で、ハフマン符号は平均符号語長を最小にする。
|
1951年、MITの大学院生だったハフマンは、ファノ教授の情報理論の授業で、期末試験を受けるかわりにレポートを書く道を選びました。課題は「最も効率のよい2進符号を求めよ」。実はこれは、ファノ自身やシャノンが取り組んで最適な方法を見つけられずにいた問題でしたが、ファノはそのことを告げていませんでした。ハフマンは何か月も試行錯誤しても最適性を証明できる方法が見つからず、あきらめて試験勉強を始めようとしたところで、頻度の小さい側から木を組み立てるこのアルゴリズムを思いつき、最適性の証明にも成功します。後に彼は、教授やシャノンが苦労した問題だと知っていたら挑戦しなかったかもしれない、と振り返っています(参照:Scientific American 1991年9月号の紹介記事)。ハフマン符号は現在もZIP、JPEG、PNG、MP3など多くの圧縮形式の構成要素として使われています。 |
3. 情報量とエントロピー — 圧縮の限界
ハフマン符号より平均符号語長の短い符号はもう作れないのでしょうか。この問いに答えるには、そもそも「そのデータには情報がどれだけ詰まっているのか」を測る物差しが必要です。シャノンはこの物差しを確率から作りました。
3.1. 自己情報量
友人が1から8までの数を1つ思い浮かべ、あなたが「はい/いいえ」で答えられる質問で当てるとします。「5以上?」「3以上?」のように候補を半分ずつに絞れば、ちょうど3回の質問で答えが決まります。8通りから1つを知ることは、2択の答え3回分、つまり3ビット分の情報を得ることだと考えられます。候補が等確率で8通りなら、1つの候補の確率は1/8であり、\(3=\log_2 8=-\log_2\frac18\) です。
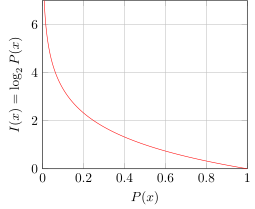
この考え方を、確率が等しくない場合にも広げたのがシャノンの定義です。確率 \(P(x)\) で生起する事象 \(x\) が起きたことを知ったとき、得られる情報量(自己情報量)を
と定義します。単位はシャノンにちなんでSh(シャノン)またはビットです。公平なコインの表が出たと知る情報量は \(-\log_2\frac12=1\) Shです。この定義は次の2つの直観を数式にしたものです。
-
起こりにくいことほど情報が多い: ある日の天気を「雨」「雨ではない」の2通りで扱い、確率を3%と97%とするモデルを考えます。その日「雨だった」と知る情報量は \(-\log_2 0.03\approx5.06\) Sh、「雨ではなかった」と知る情報量は \(-\log_2 0.97\approx0.04\) Shです。確率1で必ず起きることを知っても、情報量は \(-\log_2 1=0\) です。ここで測っているのは、このモデルのもとでの「知らせの意外さ」であって、予報そのものの価値や正確さではありません。
-
独立な事象の情報量は足し算になる: 独立な事象 \(x, y\) が両方起きる確率は \(P(x)P(y)\) なので、\(-\log_2 P(x)P(y) = -\log_2 P(x) - \log_2 P(y)\) です。たとえばコインを2回投げて「表・表」と知る情報量は、1回分の1 Shを2回足した2 Shです。対数を使うのはこの性質のためです。
3.2. エントロピー — 平均情報量
情報源が記号 \(x_1, x_2, \ldots, x_n\) をそれぞれ確率 \(P(x_1), P(x_2), \ldots, P(x_n)\) で、毎回独立に生成するとします(記憶のない情報源)。この情報源から記号を1つ受け取るときに得られる情報量の期待値
を情報源のエントロピー(平均情報量)とよびます。確率0の項は \(0\log_2 0=0\) とする約束で扱います。エントロピーは「次に何が出るかの予測しにくさ」の平均的な大きさです。たとえば公平なコインのエントロピーは \(\frac12\cdot 1+\frac12\cdot 1=1\) Shですが、表が確率0.9で出る偏ったコインでは
と小さくなります。ほとんど表が出るとわかっているので、結果を知っても平均的にはあまり驚かないからです。\(n\) 種類の記号をもつ情報源のエントロピーは、すべての記号が等確率のとき最大値 \(\log_2 n\) をとります。
| 【例】 |
5つの記号が確率 \(P(\TT e)=\frac12, P(\TT a)=\frac14, P(\TT d)=\frac18, P(\TT b)=P(\TT c)=\frac1{16}\) で生起する情報源のエントロピーは、
\[H(X)=\frac12\cdot 1+\frac14\cdot 2+\frac18\cdot 3+\frac1{16}\cdot 4+\frac1{16}\cdot 4 = 1.875 \;[\text{Sh}]\]
|
この例でハフマン符号を構成すると、符号語は \(C(\TT e)=\TT 0\), \(C(\TT a)=\TT{10}\), \(C(\TT d)=\TT{110}\), \(C(\TT b)=\TT{1110}\), \(C(\TT c)=\TT{1111}\) となり、各記号の符号語長はちょうど \(-\log_2 P(x)\) に一致します。平均符号語長も1.875ビットで、エントロピーと一致します。これは偶然ではありません。
3.3. 情報源符号化定理
シャノンは、エントロピーが圧縮の限界であることを証明しました。
【情報源符号化定理】 記憶のない情報源 \(X\) の記号を符号記号 \(\TT 0, \TT 1\) で符号化するとき、平均符号語長 \(L\) が
を満たす瞬時符号を構成できる。また、どのような一意復号可能な符号でも \(L\) を \(H(X)\) より小さくすることはできない。
つまり、平均符号語長はエントロピー未満にはできず、かつエントロピーに1を加えた値未満までは近づけられます。この下限 \(H(X)\) を情報源符号化におけるシャノン限界とよびます。前節の例のように、すべての生起確率が \(2^{-k}\)(\(k\) は正の整数)の形のときはハフマン符号がちょうど限界を達成し、一般のときも記号をいくつかまとめて符号化(ブロック符号化)すれば、1記号あたりの平均符号語長をいくらでも \(H(X)\) に近づけられます。
ハフマン符号の節の例でも確かめてみます。記号列 \(\TT{cbaccbcdacadbbc}\) の各記号の出現割合 \(\frac{3}{15},\frac{4}{15},\frac{6}{15},\frac{2}{15}\) を生起確率とみなすと、エントロピーは
です。ハフマン符号の平均符号語長1.93ビットは、たしかに \(1.89\leq L<2.89\) の範囲に入っています。確率が \(2^{-k}\) の形ではないため、ぴったり1.89にはなりません。
|
一意復号可能な符号の符号語長がとりうる値にはクラフト・マクミランの不等式とよばれる制約があり、この定理はそこから導かれます。名前だけ覚えておけば、専門書を読むときの道しるべになります。 |
3.4. 圧縮しきったデータの姿
シャノン限界まで圧縮されたビット列はどのような姿をしているでしょうか。符号記号が \(\TT 0\) と \(\TT 1\) の2種類で、\(\TT 0\) の生起確率を \(p\) とすると、符号記号1つが運べる情報量は、確率 \(p\), \(1-p\) の2値情報源のエントロピーを \(p\) の関数とみたエントロピー関数
で与えられます。グラフを見ると、\(H(p)\) が最大値1をとるのは \(p=0.5\) のとき、つまり \(\TT 0\) と \(\TT 1\) が等確率で現れるときだけです。\(p=0.1\) なら \(H(0.1)\approx 0.469\) で、符号記号1つが運ぶ情報量は半分以下になります(この値は後の通信路容量でも使います)。
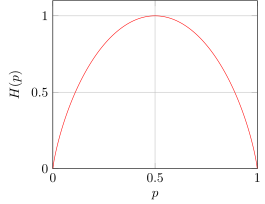
圧縮に使える規則性が残っていれば、まだ圧縮できる余地があります。ただし、0と1が半々に現れるだけでは「ランダム」とはいえません。01010101… も半々ですが、次のビットを簡単に予測できます。記号同士の依存関係も調べる必要があります。
十分に圧縮したファイルは、同じ方式でもう一度圧縮してもほとんど縮まないことが多く、むしろヘッダー分だけ大きくなることもあります。しかし、形式を示すヘッダーや別のモデルで捉えられる規則性が残るため、「圧縮データはランダム列と区別できない」と一般には断言できません。圧縮と暗号化も別の処理です。
3.5. 言語の冗長度
英語のアルファベット26文字と空白の27記号がすべて等確率で現れるとすれば、1文字のエントロピーは \(\log_2 27\approx 4.75\) Shです。しかし実際の英文では文字の頻度に偏りがあり(\(\TT e\) や空白が多い)、さらに \(\TT t\) の後には \(\TT h\) が来やすいといった強い文脈依存があります。シャノンは1951年、英文の続きの文字を人に1文字ずつ当てさせる実験を行い、100文字ほどの文脈があれば次の1文字のもつ情報量はおよそ1 Sh(推定の上限で1.3 Sh、下限で0.6 Sh程度)まで下がると見積もりました(Shannon, Prediction and Entropy of Printed English)。最大値4.75 Shに対する差の割合を冗長度といい、上限の1.3 Shを使っても
です。シャノン自身は冗長度をおよそ75%としています。つまり英文の7割以上は、前後から予測できる冗長な部分だとみなせます(この種の推定値は、対象記号や推定方法によって文献ごとに幅があります)。日本語など他の言語でも、大きな冗長性が報告されています。冗長だからこそ、多少聞き取れなくても会話が成立し、流し読みでも大意がつかめるのです。この「冗長性はノイズへの耐性を生む」という観察が、次の話題への橋渡しになります。
4. 誤り訂正 — シャノンによる視点の転換
4.1. ノイズのある通信路
ここまでは、データから冗長性を取り除く話でした。今度は逆に、冗長性をあえて足す話です。
通信路や記憶装置には、電波干渉、ディスクの傷、宇宙放射線などによるノイズが避けられません。デジタルデータでは、たった1ビットの反転がプログラムのクラッシュや暗号データの復号不能を引き起こすことがあります。
シャノンは通信を次の図のようにモデル化しました。送信者のメッセージは符号化されて通信路に送り出され、通信路ではノイズによって一部の記号が化けます。受信側は受け取った記号列を復号して、元のメッセージを取り出します。前節までの圧縮は「符号化で冗長性を除く」操作でした。ここから扱う誤り訂正は、「符号化で冗長性を足し、復号でその冗長性を使って誤りを直す」操作です。
話を単純にするため、次のモデルを考えます。送信する記号は \(\TT 0\) と \(\TT 1\) のみで、通信路を通ると、各記号は確率 \(p\) で独立に反転して(\(\TT 0\) なら \(\TT 1\) に、\(\TT 1\) なら \(\TT 0\) に化けて)受信されます。\(p\) をビット誤り率とよび、このような通信路を2元対称通信路とよびます。「対称」とは、\(\TT 0\) が \(\TT 1\) に化ける確率と \(\TT 1\) が \(\TT 0\) に化ける確率が同じ \(p\) だという意味です。
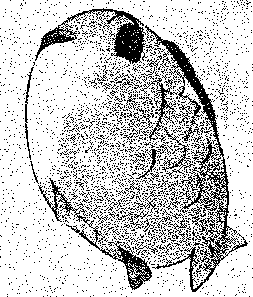
たとえば \(p=0.1\)(1割のノイズ)の通信路に白黒画像の各画素を1ビットとして通すと、左の画像は右のようになります。
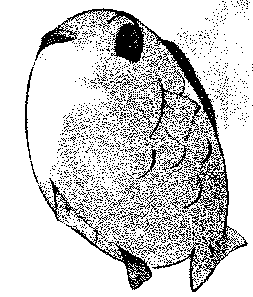
図 8. 送信した画像
|
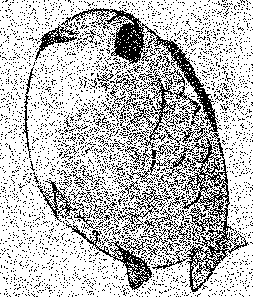
図 9. 誤り率0.1の通信路を通した画像
|
必要とされる信頼性は、この例よりはるかに高いのが普通です。たとえば毎日1GBを1年間読み出すと約2.9×10¹²ビットになりますから、年間を通してどこか1ビットでも誤る確率を数%に抑えたければ、1記号あたりの誤り率を10-14程度にまで下げる必要があります。1割も誤る通信路で、どうすればそんな信頼性を実現できるのでしょうか。
4.2. 素朴な方法 — 繰り返し符号
すぐ思いつくのは、同じ記号を繰り返し送ることです。\(\TT 0\) を \(\TT{000}\)、\(\TT 1\) を \(\TT{111}\) と3倍にして送り、受信側は3個ずつ区切って多数決をとります。記号列 \(\TT{01001}\) なら次のようになります(赤が水増しした分)。
\(\TT 0{\color{red}{\TT{00}}}\ \TT 1{\color{red}{\TT{11}}}\ \TT 0{\color{red}{\TT{00}}}\ \TT 0{\color{red}{\TT{00}}}\ \TT 1{\color{red}{\TT{11}}}\)
これを繰り返し符号といいます。受信側で多数決をとる様子を次の図に示します。
3個のうち1個までの反転なら正しく復号でき、2個以上反転すると誤ります。2個だけ反転する確率は、どの2個かの選び方が3通りあるので \(3p^2(1-p)\)、3個とも反転する確率は \(p^3\) です。したがって復号後の誤り率は
となり、\(e_3(0.1)=0.03-0.002=0.028\) です。誤り率10%が約3%に下がりました(下図)。
反転が独立で \(0\leq p<0.5\) なら、繰り返し回数 \(N\)(多数決のため奇数とします)を増やせば、誤り率はいくらでも下げられます。しかし、ただではすみません。1ビットの情報を送るのに \(N\) 個の記号を使うので、記号1つあたりが運ぶ情報量、つまり伝送速度は
に落ちてしまいます。\(p=0.1\) の通信路で目標の誤り率10-14を達成するには \(N=57\) が必要で、伝送速度は57分の1、つまり1GBを送るのに57GB送ることになります。これではとても使い物になりません。
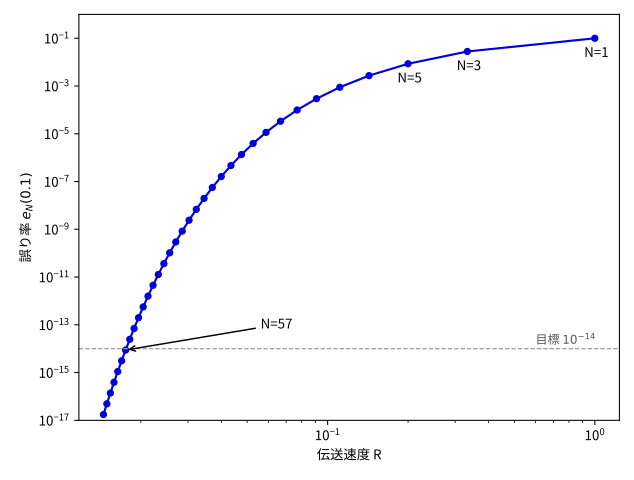
このグラフが示すとおり、繰り返し符号では誤り率を0に近づけようとすると、伝送速度も0に近づいてしまいます。
4.3. シャノン以前の見方
シャノンが登場するまで、通信技術者の常識はこの繰り返し符号の延長線上にありました。つまり、
誤り率を下げたければ、そのぶん伝送速度(あるいは送信電力や帯域といった資源)を犠牲にするしかない。誤り率を限りなく0に近づけるには、速度を限りなく0に近づけるしかない。
という見方です。信頼性と速度は際限のないトレードオフの関係にあり、「ノイズのある通信路で、速度を保ったまま誤りをほぼなくす」などということは、繰り返し符号だけからは実現できそうに見えません。これがすべての符号の限界なのでしょうか。
4.4. 通信路符号化定理
シャノンはこの常識を根底から覆しました。
【通信路符号化定理】 どの通信路にも、その通信路固有の値である通信路容量 \(C\) が定まる。伝送速度 \(R\) が
でありさえすれば、復号後の誤り率をいくらでも0に近づける符号が存在する。逆に \(R>C\) では、誤り率を0に近づけることはできない。
この定理の要点は \(R<C\) という条件の意味にあります。速度を0に向かって下げ続ける必要はなく、容量 \(C\) を下回る一定の速度を保ったまま、誤り率だけを好きなだけ0に近づけられるのです。ただし、そのためには符号のブロック長を十分長くする必要があり、遅延や計算量などの代償があります。有限の長さの実用的な符号では、速度と誤り率の間のトレードオフは残ります。ここでは、各回の通信が独立な、記憶のない通信路について述べています。
次の図は、容量 \(C\) が「誤り率を限りなく0に近づけられる速度の上限」であることを示す概念図です。\(R>C\) でも、ある程度の誤りを許せば通信できます。例えば \(p=0.1\) の通信路で符号化せずに送れば、\(R=1\)、ビット誤り率0.1です。容量を超える速度の点すべてが達成不可能なわけではありません。参照:Shannon, A Mathematical Theory of Communication(1948)。
ただし、シャノンの証明は「そのような符号が存在する」ことを示す存在証明であって、実用的な符号の作り方を与えるものではありませんでした。圧縮のほうはハフマンのアルゴリズムがすぐに見つかったのと対照的に、容量に迫る実用的な誤り訂正符号は長年見つかりませんでした。1993年に発表されたターボ符号や、1960年代初めに考案されながら長く顧みられず1990年代に再発見されたLDPC符号によって限界にほぼ迫れるようになるまで、定理の発表から半世紀近くかかりました。現在では、携帯電話(5G)、Wi-Fi、QRコード、深宇宙探査機との通信まで、あらゆる場面で誤り訂正符号が働いています。傷のついたCDが再生でき、かすれたQRコードが読み取れるのは、この理論の恩恵です。
4.5. 2元対称通信路の容量
通信路容量 \(C\) の正確な定義(相互情報量の最大値)は専門書に譲り、ここでは結果だけ示します。ビット誤り率 \(p\) の2元対称通信路の容量は、エントロピー関数 \(H(p)\) を用いて
となります。直観的には、記号1つは本来1ビットの情報を運べるはずですが、受信者から見ると「受け取った記号が反転したものかどうか」という不確かさ \(H(p)\) が残るため、そのぶんを差し引いた量が実際に伝わる、と読めます。
-
\(p=0\) (ノイズなし)なら \(C=1\)。記号1つで1ビットを運べます。
-
\(p=0.1\) なら \(C=1-H(0.1)\approx 0.53\)。9割の記号は正しく届いているのに、容量は0.53ビットしかありません。どの記号が反転したのか受信側にはわからないからです。それでも、速度0.53ビット/記号の直前までは、誤り率をほぼ0にできるのです。
-
\(p=0.5\) なら \(H(0.5)=1\) より \(C=0\)。受信記号は送信記号と無関係なコイン投げと同じになり、何も伝わりません。
\(p=0.1\) の通信路で3回繰り返し符号を使うと、速度は \(R=1/3\approx 0.33\) で容量0.53より小さいのに、誤り率は0.028までしか下がりませんでした。定理は、同じ速度1/3のままでも、もっと長いブロックでうまく作った符号を使えば誤り率をいくらでも小さくできる、と言っています。繰り返し符号は、容量を使い切れていない符号なのです。
4.6. 誤りを見つけ、場所を突き止める — パリティとハミング符号
では、繰り返し符号より効率のよい符号は、どのように誤りを直すのでしょうか。容量に迫る符号の仕組みは本書の範囲を超えるので、ここでは最も基本的な2つの考え方を紹介します。
パリティ検査 — 誤りを見つける
データのビット列に、全体の \(\TT 1\) の個数が偶数になるように1ビットを付け加えます。この追加ビットをパリティビットといいます。たとえば7ビットのデータ \(\TT{1011001}\) は \(\TT 1\) が4個(偶数)なので、パリティビットは \(\TT 0\) で、\(\TT{10110010}\) を送ります。
受信側で \(\TT 1\) の個数を数えて奇数なら、どこかで誤りが起きたとわかります(誤り検出)。速度は7/8と高く、水増しはわずか1ビットです。ただし、
-
どのビットが反転したのかはわからないので、直せません(再送してもらう必要があります)。
-
2ビットが同時に反転すると個数は偶数に戻り、誤りを見逃します。
ハミング符号 — 誤りの場所を突き止める
ベル研究所のリレー式計算機は、自分で誤りを検出する仕組みをもっていましたが、夜間や週末に無人で運転していると、誤りを検出するたびにその計算は打ち切られ、機械は次の仕事に移ってしまいました。これに悩まされたハミングは「誤りを検出できるなら、その位置を突き止めて直せるはずだ」と考え、1950年にハミング符号を発表します(Hamming, Error Detecting and Error Correcting Codes(1950))。
アイデアは、パリティ検査を範囲を変えて何重にもかけることです。代表的な(7,4)ハミング符号(7ビットのうち4ビットがデータ)では、4ビットのデータ \(d_1d_2d_3d_4\) に3ビットのパリティ \(p_1p_2p_3\) を付けて7ビットを送ります。次の図のように3つの円を重ねて7つの区画を作り、データとパリティを1ビットずつ置きます。
- 符号化
-
各円の中の \(\TT 1\) の個数が偶数になるように \(p_1, p_2, p_3\) を決めます。データ \(\TT{1011}\)(\(d_1=1,d_2=0,d_3=1,d_4=1\))なら、円A(\(d_1,d_2,d_4\))の1は2個なので \(p_1=0\)、円B(\(d_1,d_3,d_4\))は3個なので \(p_2=1\)、円C(\(d_2,d_3,d_4\))は2個なので \(p_3=0\) です。送る7ビットは \(d_1d_2d_3d_4p_1p_2p_3=\TT{1011010}\) です。
- 復号
-
受信した7ビットを図に戻し、各円の \(\TT 1\) の個数を数えます。奇数になった円の組み合わせを見ると、反転したビットの場所がわかります。図の②では円Bと円Cだけが奇数なので、「B と C の内側にあり、A の外側にある」区画、つまり \(d_3\) が反転したとわかり、これを元に戻します。
7つの区画は、それぞれ「どの円に含まれるか」の組み合わせがすべて異なります(Aだけ、Bだけ、Cだけ、AとB、AとC、BとC、3つとも)。そのため、7ビットのうちどれか1ビットが反転したとき、奇数になる円の組み合わせから場所が一通りに決まります。どの円も偶数なら誤りなしと判断します。
3回繰り返し符号も、ハミング符号も、ブロック(それぞれ3ビット、7ビット)の中の1ビットの誤りを訂正できます。しかし速度は、繰り返し符号の1/3に対して、ハミング符号は \(4/7\approx 0.57\) と大きく上回ります。冗長なビットを「同じものの繰り返し」ではなく「異なる範囲のパリティ」として加えることで、少ない水増しで誤りの位置まで特定できるのです。
ただし、ハミング符号でもブロック内で2ビット以上が反転すると正しく直せません。\(p=0.1\) のようにノイズの多い通信路では、7ビットのブロックが正しく復号される確率は \((0.9)^7+7\times0.1\times(0.9)^6\approx 0.85\) にとどまります。ハミング符号は誤りがまれな場面に向いており、1ビットの訂正に加えて2ビットの誤りの検出もできるよう1ビット追加した形が、コンピューターのECCメモリなどで使われています。ノイズの多い無線通信などでは、より長いブロックの強力な符号が使われます。
|
遺伝情報にも、冗長性と誤りへの対処を区別して考えられる例があります。標準遺伝暗号では複数のコドンが同じアミノ酸を指定するため、一部の塩基置換ではアミノ酸が変わりません。ただし、これは元のDNA配列を復元する「訂正」ではありません。DNA複製時の校正や修復は別の仕組みです。 |
5. 練習問題
基本の確認から始め、計算の練習、考える問題の順に並べています。解答は、自分で解いてから開いてください。対数の値は \(\log_2 3\approx 1.585\), \(\log_2 5\approx 2.322\), \(\log_2 13\approx 3.700\) などを使ってかまいません(関数電卓や表計算ソフトで求めてもよい)。
次の知らせを受け取ったときの自己情報量を求めよ。
(1) 公平なサイコロを1回振って「1の目が出た」と知る。
(2) 同じサイコロで「偶数の目が出た」と知る。
(3) ジョーカーを除く52枚のトランプをよく切って1枚引き、「ハートのエースだ」と知る。
(4) (3)の1枚について「ハートだ」と「エースだ」を別々に知ったときの自己情報量をそれぞれ求め、その和を(3)と比べよ。
解答
(1) \(P=\frac16\) なので \(I=-\log_2\frac16=\log_2 6=1+\log_2 3\approx 2.58\) Sh。
(2) 偶数の目は2, 4, 6の3通りなので \(P=\frac12\)、\(I=1\) Sh。「偶数か奇数か」という2択の答え1回分です。(1)より情報量が少ないのは、(2)の知らせを受けても目が3通り残っていて、答えがまだ絞り切れていないからです。
(3) \(P=\frac1{52}\) なので \(I=\log_2 52=2+\log_2 13\approx 5.70\) Sh。
(4) 「ハート」は \(P=\frac14\) で2 Sh、「エース」は \(P=\frac4{52}=\frac1{13}\) で \(\log_2 13\approx 3.70\) Sh。和は約5.70 Shで(3)と一致します。スートと数字は独立なので \(P(\text{ハートのエース})=\frac14\times\frac1{13}\) となり、対数をとると情報量は足し算になります。独立でない事象どうしでは、このように単純に足すことはできません。
次の情報源のエントロピーを求めよ。
(1) 表と裏が確率 \(\frac12\) ずつ出るコイン
(2) 表が確率0.9、裏が確率0.1で出るコイン
(3) 4つの記号が確率 \(\frac12, \frac14, \frac18, \frac18\) で出る情報源
(4) 4つの記号が等確率 \(\frac14\) ずつで出る情報源
(5) (3)と(4)ではどちらのエントロピーが大きいか。その理由を「予測しやすさ」の観点から説明せよ。
解答
(1) \(H=\frac12\cdot 1+\frac12\cdot 1=1\) Sh。
(2) \(H=-0.9\log_2 0.9-0.1\log_2 0.1\approx 0.9\times 0.152+0.1\times 3.322\approx 0.47\) Sh。エントロピー関数で \(H(0.1)\approx 0.469\) です。
(3) 各記号の自己情報量は1, 2, 3, 3 Shなので、\(H=\frac12\cdot 1+\frac14\cdot 2+\frac18\cdot 3+\frac18\cdot 3=1.75\) Sh。
(4) \(H=4\times\frac14\cdot 2=2\) Sh(\(=\log_2 4\))。
(5) (4)のほうが大きいです。(3)では半分の確率で同じ記号が出るので「たぶんこれだろう」と予測が当たりやすく、結果を知ったときの驚きが平均的に小さくなります。(4)はどの記号も同じくらい出るので予測の手がかりがなく、4記号の情報源として最大の \(\log_2 4=2\) Shになります。
次の2つの符号について答えよ。
| 記号 | \(\TT a\) | \(\TT b\) | \(\TT c\) | \(\TT d\) |
|---|---|---|---|---|
\(C_3\) の符号語 |
\(\TT{0}\) |
\(\TT{0111}\) |
\(\TT{011}\) |
\(\TT{01}\) |
\(C_4\) の符号語 |
\(\TT{0}\) |
\(\TT{1110}\) |
\(\TT{010}\) |
\(\TT{11}\) |
(1) \(C_3\) と \(C_4\) はそれぞれ瞬時符号か。語頭条件を用いて理由とともに答えよ。
(2) \(C_3\) は一意復号可能か。符号語の形に着目して考察せよ。
(3) 本文の瞬時符号 \(C_1\)(\(\TT a\mapsto\TT 0\), \(\TT b\mapsto\TT{100}\), \(\TT c\mapsto\TT{11}\), \(\TT d\mapsto\TT{101}\))を用いて、記号列 \(\TT{dacbad}\) を符号化せよ。
(4) 符号 \(C_1\) による符号記号列 \(\TT{1000101110100}\) を復号せよ。
解答
(1) どちらも瞬時符号ではありません。\(C_3\) では \(C_3(\TT a)=\TT 0\) が \(C_3(\TT d)=\TT{01}\) の語頭になっています(さらに \(\TT{01}\) は \(\TT{011}\) の、\(\TT{011}\) は \(\TT{0111}\) の語頭です)。\(C_4\) では \(C_4(\TT a)=\TT 0\) が \(C_4(\TT c)=\TT{010}\) の語頭になっています(さらに \(C_4(\TT d)=\TT{11}\) は \(C_4(\TT b)=\TT{1110}\) の語頭でもあります)。語頭条件は、1組でも破れていれば満たされません。
(2) 一意復号可能です。\(C_3\) の符号語はいずれも「\(\TT 0\) の後に \(\TT 1\) が0個以上続く」形をしており、\(\TT 0\) が現れたら必ず新しい符号語の始まりです。したがって、符号記号列を \(\TT 0\) の直前で区切れば復号は一通りに定まります。たとえば \(\TT{0110010}\) は \(\TT{011|0|01|0}\) と区切れて \(\TT{cada}\) です。ただし、\(\TT 0\) を読んだ時点では次の記号を見るまで \(\TT a\) か \(\TT d\)(あるいは \(\TT c, \TT b\))かが確定しないため、瞬時符号ではありません。一意復号可能であることと瞬時であることは別の性質で、瞬時符号はつねに一意復号可能ですが、その逆は成り立ちません。
(3) \(C_1(\TT d)C_1(\TT a)C_1(\TT c)C_1(\TT b)C_1(\TT a)C_1(\TT d)\) をつなげて、
\(\uB{101}d\uB{0}a\uB{11}c\uB{100}b\uB{0}a\uB{101}d\) より \(\TT{1010111000101}\)
(4) 左から読み進めて葉に到達するたびに記号を確定すると、
\(\uB{100}b\uB{0}a\uB{101}d\uB{11}c\uB{0}a\uB{100}b\) より \(\TT{badcab}\)
(1) \(\TT{a},\TT{b},\TT{c},\TT{d},\TT{e},\TT{f}\) の6記号の固定長符号の中で、もっとも符号語長が短い符号を1つ与え、符号の表を示せ。ただし、符号記号は \(\TT 0\) と \(\TT 1\) のみを用いるものとする。
(2) (1)の符号で \(\TT{dfcbdcbbcabdacbabaeaccbeabf}\) を符号化した場合の符号記号列長を求めよ。
(3) ハフマン符号を構成するアルゴリズムを用いて、記号列 \(\TT{dfcbdcbbcabdacbabaeaccbeabf}\) 中の出現頻度から符号を作成し、符号木と符号の表を示せ。
(4) 作成した符号によって、この記号列を符号化したときの符号記号列長と、情報源記号1つあたりの平均符号語長を求めよ。
(5) 各記号の出現割合を生起確率とみなしてエントロピーを求め、(4)の平均符号語長と比べよ。
解答
(1) 6種類の記号を区別するには、\(2^2=4<6\le 8=2^3\) より3ビット必要です。素直に2進法の数の順に符号語を割り当てると、以下の符号が得られます(6個の異なる3ビット列を割り当てていれば正解です)。
| 記号 | \(\TT a\) | \(\TT b\) | \(\TT c\) | \(\TT d\) | \(\TT e\) | \(\TT f\) |
|---|---|---|---|---|---|---|
符号語 |
\(\TT{000}\) |
\(\TT{001}\) |
\(\TT{010}\) |
\(\TT{011}\) |
\(\TT{100}\) |
\(\TT{101}\) |
(2) 記号列の長さは27なので、27×3=81です。
(3) 記号の出現回数は以下のとおりです。
| 記号 | \(\TT a\) | \(\TT b\) | \(\TT c\) | \(\TT d\) | \(\TT e\) | \(\TT f\) |
|---|---|---|---|---|---|---|
出現回数 |
6 |
8 |
6 |
3 |
2 |
2 |
頻度の最も小さい2つをまとめる操作を繰り返します。
-
\(\TT e\)(2)と \(\TT f\)(2)をまとめて4
-
残りは a6, b8, c6, d3, (4)。最小の \(\TT d\)(3)と(4)をまとめて7
-
残りは a6, b8, c6, (7)。最小の \(\TT a\)(6)と \(\TT c\)(6)をまとめて12
-
残りは b8, (7), (12)。最小の(7)と \(\TT b\)(8)をまとめて15
-
最後に(15)と(12)をまとめて根(27)
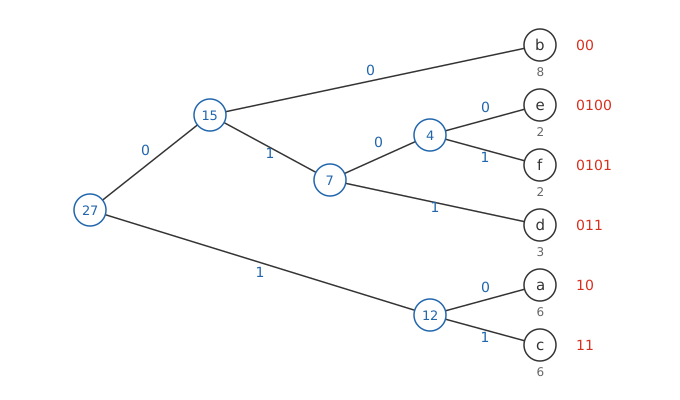
上側の辺に \(\TT 0\)、下側の辺に \(\TT 1\) を割り当てると、たとえば次の符号木が得られます。
| 記号 | \(\TT a\) | \(\TT b\) | \(\TT c\) | \(\TT d\) | \(\TT e\) | \(\TT f\) |
|---|---|---|---|---|---|---|
符号語 |
\(\TT{10}\) |
\(\TT{00}\) |
\(\TT{11}\) |
\(\TT{011}\) |
\(\TT{0100}\) |
\(\TT{0101}\) |
\(\TT 0\) と \(\TT 1\) の割り当てには任意性がありますので、この表と異なっていても、瞬時符号でかつ各記号の符号語長が同じ(a, b, c が2、d が3、e, f が4)であれば正解です。この問題ではどの段階でも「最小の2つ」の選び方で符号語長は変わりません。よくある誤りは、2.で(4)と \(\TT a\) や \(\TT c\) をまとめてしまうことです。常にその時点で最小の2つを選びます。
(4) 符号記号列長は(出現回数)×(符号語長)の合計で、
となり、固定長符号の81に対して65に削減できました。平均符号語長は65/27≈2.41ビットで、固定長符号の3ビットより短くなっています。
(5) 出現割合は \(\frac{6}{27},\frac{8}{27},\frac{6}{27},\frac{3}{27},\frac{2}{27},\frac{2}{27}\) なので、
です。平均符号語長2.41ビットはエントロピーをわずかに上回っており、情報源符号化定理の \(H\leq L<H+1\) を満たしています。記号1つずつに符号語を割り当てる限り、2.41ビットより短くはできません。
4つの記号 \(\TT a, \TT b, \TT c, \TT d\) をそれぞれ確率0.4, 0.3, 0.2, 0.1で独立に出す情報源がある。
(1) ハフマン符号を構成し、符号木と各記号の符号語を示せ。
(2) 平均符号語長を求め、2ビットの固定長符号と比べよ。
(3) この情報源のエントロピーを求め、(2)と比べよ。
(4) 平均符号語長をエントロピーにさらに近づけるにはどうすればよいか。
解答
(1) 確率の小さい2つを順にまとめます。\(\TT d\)(0.1)と \(\TT c\)(0.2)で0.3、次に \(\TT b\)(0.3)と(0.3)で0.6、最後に \(\TT a\)(0.4)と(0.6)で根になります。2回目は0.3が2つ並びますが、残りの0.4より小さいのはこの2つなので迷いません。
符号語はたとえば \(\TT a=\TT 0\), \(\TT b=\TT{10}\), \(\TT c=\TT{110}\), \(\TT d=\TT{111}\) です(0と1を入れ替えたものも正解)。
(2) \(L=0.4\times 1+0.3\times 2+0.2\times 3+0.1\times 3=1.9\) ビットで、固定長の2ビットより5%短くなります。確率を使う問題では、出現回数のかわりに確率で重み付けした平均をとります。
(3) エントロピーは
です。\(1.85\leq 1.9<2.85\) で、情報源符号化定理のとおりです。確率が \(2^{-k}\) の形ではないので、ハフマン符号でもエントロピーとちょうど等しくはなりません。
(4) 記号を2個、3個とまとめたものを1つの記号とみなしてハフマン符号を作る(ブロック符号化)と、1記号あたりの平均符号語長をエントロピーの1.85にいくらでも近づけられます。記号1つずつに符号語を割り当てる方法のままでは1.9より短くできません。
(1) 7ビットのデータ \(\TT{1101101}\) に、全体の \(\TT 1\) の個数が偶数になるようにパリティビットを付けた8ビットを求めよ。
(2) パリティ検査では、1ビットの誤りは検出できるが訂正はできず、2ビットの誤りは検出もできない。それぞれ理由を説明せよ。
(3) 本文のハミング符号(円A: \(d_1,d_2,d_4,p_1\)、円B: \(d_1,d_3,d_4,p_2\)、円C: \(d_2,d_3,d_4,p_3\))で、4ビットのデータ \(\TT{0110}\)(\(d_1d_2d_3d_4\))を符号化し、7ビット \(d_1d_2d_3d_4p_1p_2p_3\) を求めよ。
(4) 同じハミング符号で7ビット \(\TT{1101011}\) を受信した。誤りは高々1ビットとして訂正し、元の4ビットのデータを求めよ。
(5) 同じく \(\TT{0110100}\) を受信した。誤りは高々1ビットとして、元の4ビットのデータを求めよ。
解答
(1) \(\TT{1101101}\) の \(\TT 1\) は5個(奇数)なので、パリティビットは \(\TT 1\) で、\(\TT{11011011}\) です。
(2) 1ビット反転すると \(\TT 1\) の個数が1つ増えるか減るので、偶数が奇数になり、誤りがあることはわかります。しかし、8ビットのどれが反転しても同じく「奇数」になるだけなので、場所を特定できず訂正できません。2ビット反転すると、個数の偶奇が2回変わって元の偶数に戻るため、誤りのない場合と区別できません。
(3) \(d_1=0, d_2=1, d_3=1, d_4=0\) です。円A(\(d_1,d_2,d_4\))の1は1個なので \(p_1=1\)、円B(\(d_1,d_3,d_4\))は1個なので \(p_2=1\)、円C(\(d_2,d_3,d_4\))は2個なので \(p_3=0\)。送る7ビットは \(\TT{0110110}\) です。
(4) \(d_1=1,d_2=1,d_3=0,d_4=1,p_1=0,p_2=1,p_3=1\) として各円の1を数えると、円A(\(1,1,1,0\))は3個、円B(\(1,0,1,1\))は3個、円C(\(1,0,1,1\))は3個で、3つとも奇数です。3つの円すべてに含まれるのは中央の \(d_4\) なので、\(d_4\) を0に戻して \(\TT{1100011}\)。元のデータは \(\TT{1100}\) です(念のため、\(\TT{1100}\) を符号化すると \(p_1p_2p_3=\TT{011}\) となり一致します)。
(5) \(d_1=0,d_2=1,d_3=1,d_4=0,p_1=1,p_2=0,p_3=0\) として各円の1を数えると、円A(\(0,1,0,1\))は2個で偶数、円B(\(0,1,0,0\))は1個で奇数、円C(\(1,1,0,0\))は2個で偶数です。円Bだけが奇数なので、円Bだけに含まれる \(p_2\) が反転していました。データ部分は無事で、元のデータは \(\TT{0110}\) です((3)の符号語 \(\TT{0110110}\) の \(p_2\) が反転したものです)。パリティビット自体が化けることもある、という点に注意しましょう。
ビット誤り率 \(p=0.1\) の2元対称通信路を考える。
(1) 5回繰り返し符号(各ビットを5回送り、多数決で復号する)の伝送速度と、復号後の誤り率を求めよ。
(2) この通信路の通信路容量を求めよ。\(H(0.1)\approx 0.469\) を使ってよい。
(3) 次の各主張は正しいか。理由とともに答えよ。
(a) 伝送速度0.5のまま、復号後の誤り率を \(10^{-14}\) 以下にできる符号が存在する。
(b) 伝送速度0.6のまま、復号後の誤り率をいくらでも0に近づけられる符号が存在する。
(c) 伝送速度0.6では、どのように符号化しても情報はまったく伝わらない。
解答
(1) 速度は \(R=\frac15=0.2\)。5個のうち3個以上が反転すると誤るので、
誤り率は約0.86%で、3回繰り返し符号の2.8%より下がりましたが、速度は1/3から1/5に落ちています。(\(\binom53=10\) は5個から3個を選ぶ組み合わせの数です。)
(2) \(C=1-H(0.1)\approx 1-0.469=0.531\) ビット/記号。
(3)
(a) 正しい。\(0.5<C\approx 0.531\) なので、通信路符号化定理により、ブロック長を十分長くすれば誤り率をいくらでも小さくできる符号が存在します。ただし、定理は存在を保証するだけで、ブロック長は非常に長くなることがあります。
(b) 誤り。\(0.6>C\) なので、速度0.6を保ったまま誤り率を0に近づけることはできません。
(c) 誤り。容量を超える速度でも、ある程度の誤りを許せば情報は伝わります。たとえば符号化せずに送れば速度1、誤り率0.1です。容量は「誤り率を0に近づけられる速度の上限」であって、「通信できる速度の上限」ではありません。
コンピューターに保存されたファイルは \(\TT 0\) と \(\TT 1\) の並びです。そこで \(\TT 0\) を白、\(\TT 1\) を黒のドットとして順に並べ、ビット列を画像として見てみます。「吾輩は猫である」の電子テキスト(Shift_JIS)から、次の2つの画像を作りました。
| (i) |
元のテキストファイルから連続する約3万2千ビットを取り出した画像 |
| (ii) |
テキストを圧縮ツール(bzip2)で圧縮したファイルから連続する約3万2千ビットを取り出した画像 |
この2つの画像を、順序を伏せて以下に示します。
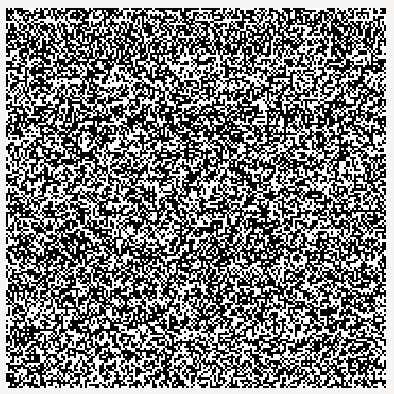
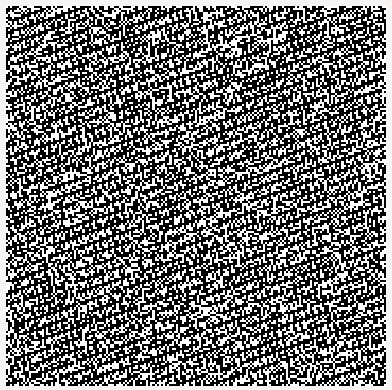
(1) 画像(a)と画像(b)は、それぞれ(i)と(ii)のどちらから作られたものか推測せよ。
(2) (1)でそのように考えた理由を述べよ。
解答
画像(a)が圧縮ファイル(ii)、画像(b)が元のテキストファイル(i)です。
画像(b)には斜めの縞、つまり規則的な繰り返しパターンが見えます。Shift_JISでは日本語の文字の多くが2バイト(16ビット)で表されるため、16ビットごとの周期性が現れるのです。画像の1行のビット数が16の倍数からずれていると、周期の位置が行ごとに少しずつずれるので、縞は斜めに見えます。規則性があるということは、前を読めば先がある程度予測できるということであり、まだ冗長性が残っている、つまり圧縮の余地があることを意味します。
一方、画像(a)は0と1がほぼ半々の砂嵐のように見えます。圧縮によって目立つ規則性が減った姿だと考えられます。ただし、外見や0と1の割合だけで圧縮の有無を確定することはできません。ここでは、提示した2枚の画像と作成方法を比較した説明です。
なお、「黒い部分が多いほうが圧縮ファイル」という見方は誤りです。もしそうなら真っ黒な画像が最も圧縮されたデータになってしまいますが、長さが既知で、必ず1を出すとわかっている情報源なら、1記号あたりの情報量は0です(白黒を反転しても情報量は変わりません)。
ちなみに、bzip2による圧縮は可逆圧縮、つまり元のデータを完全に復元できる圧縮です(749KBが252KBになりました)。第2章で触れたJPEGや、MP3のような非可逆圧縮とは区別してください。